언어 조건화 & 텍스트 어텐션 구조적 사망
지시문(텍스트)이 액션에 영향을 미치는 진짜 언어조건화 VLA로 가려는 시도들 — 그리고 반복적으로 발견된 'text attention = 0%' 구조적 문제.
압축 요약
Text attention = 0%는 여러 백본에서 독립적으로 재확인된 구조적 현상이다. Kosmos-2 기반 End-to-End VLA(Exp1~41C, head-only인 Exp15 포함)는 전 층에서 text attention이 0.000%로 붕괴돼 있으며, 이는 우리 LoRA 학습 탓이 아니라 Google-robot post-training 등 백본 자체가 이미 텍스트 경로를 죽여놓은 결과로 보인다. 원인은 지름길 학습(shortcut)이다 — 이미지와 텍스트를 동시에 넣고 액션을 직접 엔드투엔드로 학습시키면, 신경망은 텍스트 조건보다 훨씬 학습하기 쉬운 이미지의 주행 궤적 통계(FORWARD bias)를 먼저 학습해버려 텍스트를 무시하는 지름길에 안주한다(CH17).
"grounding까지만 언어가 관여하고, 액션은 순수 기하학"이라는 분해형(Decomposed) 파이프라인이 현재 우리 리소스(150ep 규모)에서 안전하게 도달 가능한 최대치라는 게 CH38의 판정이다. π0/TinyVLA/SmolVLA/RoboVLMs는 모두 언어가 액션 생성까지 직접 관여하지만, 우리는 텍스트→bbox(Stage1 PaliGemma2 LoRA, 분리도 gap +95%p 실증)까지만 끊어서 기하 제약을 강제하고, Stage2 MLP는 cx/area 같은 순수 좌표만 받는다.
"객체가 뭔지"는 신경망이 강하게 반영하지만 "어느 쪽으로 가라"는 방향/스타일 지시는 표현(hidden state) 레벨에서도, 출력 레벨에서도 거의 도달하지 않는다. CH38-4/38-5/CH42: basket vs ball처럼 객체가 바뀌면 cos_dist 0.36~0.44로 강한 신호가 나오지만, left/right 같은 방향 지시는 cos_dist 0.03~0.05로 10배 약하고, 실제 생성 출력에서는 방향 단어가 bbox에 전혀 반영되지 않는다(4세션 전부 노이즈 수준). frozen probe로도 prompt 종류 자체는 99%로 구분되지만 이건 "다른 토큰이라 다르다"일 뿐 방향 이해가 아니며, 진짜 이미지 방향 신호는 거짓 prompt를 줘도 90%대로 전혀 안 흔들린다.
CH61에서 과거 "언어 조건화 성공"으로 보였던 실험(43ep 프록시, counterfactual changed_rate 20.3%)이 버그 수정 후(vis_feat L2-정규화 누락 수정) 정확히 0.0%로 붕괴했다 — 즉 텍스트를 참조는 하나(permutation −16.1%p) "명령"이 아니라 "경로 맥락(prior)"으로만 쓰인다. 근본 원인은 데이터 자체: 조이스틱 수집 구조상 지시문과 실제 경로가 1:1로 상관돼 있어(text-scene confound) 언어를 따르는 신호 자체가 데이터에 없다 — 코드/학습 레벨 우회(정규화 수정, bbox_scale, PG2 비전 교체, synthetic augmentation)를 모두 시도했지만 전부 무효했고, 재수집만이 유일한 해법으로 재확인됐다(61-12~61-16).
CH68은 과거 "language-conditioned" 실험(train_step2_instr_head.py, permutation drop 14.6%p)이 실제로는 라벨 누출이었음을 밝혔다 — 지시문이 path_type에서 합성돼 "curve to the left"가 정답 클래스를 자연어로 직접 지시했기 때문. 진짜 증명에는 "같은 초기 프레임 · 다른 지시문 → 다른 타겟"인 다중 객체 과제가 필요하며(비전만으로 원리적으로 풀 수 없는 구조), 액션 어휘("left/right/turn") 금지·no_text/shuffled_text/wrong_text 3종 대조군·방향 일치율을 주 지표로 사전 고정하는 프로토콜(L0~L4 단계)이 세워졌다.
L1(지시문→검출 프롬프트 교체)은 실측 완료, 성립함: 같은 이미지에서 "gray basket"→cx 0.484, "chair"→cx 0.089로 조향 부호가 55.1% 반전 — 이는 학습이나 코드 수정 없이 이미 동작하는 "language-directed target selection"이다. 하지만 액션까지 바뀌는가(L1을 액션 레벨로 확장)는 실측 결과 실패했다(68-8): bbox를 chair로 교체해도 방향 일치율 35.1%로 우연(50%)보다도 낮았다. 원인 규명(68-9, cx만 통제 변수로 스윕) 결과, 배포 헤드는 cx 0.05~0.95 전 구간에서 좌질량이 음수(우측 선호가 역전 없이 유지)로 나와, cx→조향 방향의 입력-출력 대응 자체가 헤드 안에서 붕괴돼 있다는 게 밝혀졌다. 흥미롭게도 미러 증강(65-9) 헤드는 이 cx 응답 대응관계를 정상 방향(Spearman −0.575)으로 복구시켰는데, 이는 실기 100건에서 아직 검증되지 않은 결과다.
미해결/논쟁 중: 미러증강 헤드가 실기(closed-loop) 좌측 조향 취약(CH64/66 최저 80%)을 실제로 개선하는지는 아직 100건 실기 검정을 거치지 않아 확정되지 않았다.
챕터별 원문 발췌 (시간순)
① 왜 PaliGemma로 전환했나 (Exp57 이전)
Exp1~56: Kosmos-2 기반 접근
End-to-End VLA (Exp1~25): text attention 0% → 실패
분해 접근 (Exp26~54):
HSV(색상 필터) → cx,cy
+ Kosmos-2 CLIP LoRA → visual feat
→ MLP → action
CL 96.67% 달성 ✅
한계: HSV = 규칙 기반, 객체 인식 아님
PaliGemma로 전환한 이유
교수님 5/22 반박: "basket을 본다는 증거가 없다"
→ HSV는 색상 규칙이지 객체 인식이 아님
→ 신경망이 텍스트로 물체를 특정하는 것이 필요
PaliGemma = detection pre-trained VLM
→ "detect gray basket" →
🔬 실험 목적 구조 E2E 8조합 Ablation (완료) 구성: top{2,4,6,8} × {frozen, tuned} = 8개 목적: 어떤 LoRA depth 조합이 action 예측에 유리한가 epoch: 5 epochs × ~84분 = 7시간/실험 총 학습: 56시간 (6/5~6/8, 3일) ⚠️ 핵심 발견 모든 8개 모델에서 lora_B = 0.000000 → Vision LoRA가 E2E 경로에서 gradient 미도달 원인: forward_continuous의 multimodal_embeds.requires_grad_(True)가 vision_tower를 loss 그래프에서 분리 → 실제로는 "frozen-vision E2E" 8조합 비교였음 ✅ 그럼에도 유효한 기여 Vision은 frozen이었지만 action head + proj 조합에 따른 성능 차이는 실측됨 → "어떤 depth의 LoRA가 MLP에 유리한가" 는 여전히 유효한 ablation exp64 — Vision Grounding LoRA (진행 중) 구성: SigLIP layers 19-26, q/k/v만 목적: Grounding forward에서 vision LoRA가 실제 학습되는가 데이터: 8960샘플 (V5 pos 1500 + hard-neg 7500) epoch: 15 epochs (진행 중) ✅ 핵심 차이 Grounding forward는 generate() 경로 사용 → vision_tower gradient가 정상 역전파 trainable tensors: 48개 확인 epoch 1 loss = 1.4728 ✅ (학습 중) 🎯 완료 후 비교 대상 base PG2: full-frame 0% → [결과: CH31] exp64 full-frame 92% — 뛰어넘기는커녕 붕괴 📐 실험이 말하는 논리 흐름 1 E2E Ablation: "Vision LoRA는 E2E 경로에서 구조적으로 학습 불가" 8조합 전부 lora_B=0 → RoboVLMs forward 수술 없이는 불가. 재학습(6/9 게이트 테스트)에서도 재확인. 2 reframe: "Grounding forward 경로로 우회하면 되지 않나?" Action이 아닌 BBox 탐지(grounding)는 generate() 경로 → vision까지 gradient 도달. 목적도 action이 아닌 grounding 품질 향상. 3 exp64: "Grounding LoRA는 실제로 작동하는가?" — 완료: 학습은 되나 품질 붕괴 (CH31) trainable 48개 학습 확인(gradient 도달 O). 단 실측 결과 full-frame 92%로 박스 품질 붕괴 — base PG2가 더 정확. → vision LoRA는 grounding을 악화시킴. 4 6/4 교수님 피드백 대응 범위 이 두 실험이 직접 답하는 것: R2-2 LoRA 기여도, R6 Grounding 지터링 개선 답하지 않는 것: R4(조향 오실레이션 → Y-Center Gate로 해결), R3(단일 데이터 → 새 수집 필요) 📊 실험 현황 요약 실험 조합 수 Vision LoRA 상태 핵심 결론 E2E top2_proj_frozen 1/8 lora_B=0 완료 frozen-vision E2E baseline E2E top2/4/6/8 × tuned 4/8 lora_B=0 완료 proj tuning 효과만 비교 E2E top4/6/8_proj_frozen 3/8 lora_B=0 완료 depth만 다른 frozen 비교 exp64 (Grounding LoRA) 1 48 tensors ✅ epoch 1/15 grounding 경로 vision LoRA 최초 작동 확인 판정 결과 (CH31 완료): exp64 full-frame 92% vs base PG2 0% — 미개선(붕괴). → base PG2를 최종 grounding 모델로 확정. "vision LoRA는 grounding 경로에서 gradient는 도달하나 박스 품질을 붕괴시킨다"가 결론. (전 모델 비교: Grounding Hub)
π0 · TinyVLA · SmolVLA · RoboVLMs 대비 위치 확인, instruction-grounding 연동, 다음 단계로서의 멀티 객체 데이터
CH2(Google-robot backbone 실패)·CH29-32(text attention 0% 구조적 원인)의 결론은 "end-to-end VLA는 지금 백본으로 불가능"이었다. 그렇다면 "VLA에 가장 가깝게" 가려면 어디까지 손대야 하는지를, 실제 프로덕션 VLA 4종과 구조 비교로 판단했다.
38-1. 레퍼런스 아키텍처 비교
모델VLM 백본액션 헤드언어→액션 연결학습 비용 π0(Physical Intelligence) PaliGemma 3B action expert(0.315B), flow matching 50Hz cross-attention으로 직접 연결 10,000시간 cross-embodiment TinyVLA <1B 소형 VLM diffusion head, linear projection VLM 임베딩(언어 포함) 직접 입력 pretrain 단계 없음, LoRA 5%만 SmolVLA 소형 VLM 비동기 action chunk VLM 임베딩 직접 입력 단일 GPU 학습 가능 RoboVLMs(우리 프레임워크) 8종 백본 비교(Kosmos-2 포함) 4종 policy head 비교 백본+헤드 조합에 좌우(600+ 실험) 우리 Exp01~16이 이 경로로 시도→실패 우리(지금, CH38-2) base PG2(frozen, zero-shot) MLP/LSTM(8-class) grounding까지만, action엔 미도달 0(재학습 없음) 공통점: π0·TinyVLA·SmolVLA·RoboVLMs 넷 다 언어가 액션을 만드는 부분까지 직접 들어간다(cross-attention 또는 임베딩 직접입력). 우리는 grounding에서 멈춘다 — 이게 가장 본질적인 구조적 차이.
38-2. 판단 — 지금은 "grounding까지만" 연동이 맞는 목표치
목표 수준내용우리 상황에서 타당한가 A. π0 수준(완전 재현) action expert + flow matching ❌ 비현실적 — 데이터 규모 격차 3~4 자릿수(10,000시간 vs 150 에피소드) B. TinyVLA/SmolVLA 수준(경량 재현) frozen VLM+LoRA 5%+소형 헤드, 헤드가 언어 포함 임베딩을 입력으로 받음 ⚠️ 구조는 이미 비슷(frozen+소형헤드) — 멀티 객체 주행 데이터 없이는 Exp12/13처럼 또 무시됨 C. 지금 우리 수준 언어는 객체 선택까지만, 액션은 순수 기하학 ✅ 지금 데이터/리소스로 안전하게 도달 가능한 최대치 TinyVLA의 핵심 패턴(frozen VLM + 거의 안 쓰는 LoRA + 소형 헤드)은 사실 우리 구조(frozen PG2 + MLP/LSTM)와 거의 같다. 차이는 헤드 입력이 "bbox 좌표"냐 "PG2의 실제 hidden state(언어 포함)"냐 하나뿐 — 그래서 B로 가는 길은 멀지 않다. 다만 그 한 걸음을 떼려면 멀티 객체 주행 데이터가 선행돼야 한다(38-3).
38-3. 멀티 객체 주행 데이터 — 지금 할 것 vs 나중에 할 것
구분목적규모학습에 쓰이는가 지금(검증용) 현재 구현(C 수준)이 실제 주행에서도 되는지 확인 객체당 3~5 에피소드, 기존 5종 중 2~3개로 파일럿 아니오 — 테스트만, 학습 없음 나중(B 수준 학습용) action head에 언어 신호를 실제로 학습시킬 데이터 V5 바스켓 수준(객체당 15~20ep × 경로유형) — 주 단위 작업 예 — 본 학습 투입 지금 할 일: GOAL_AREA 캘리브레이션(CH 직전 plan 참조) 후 soda에서 객체 2~3종 × 소수 에피소드로 "find the X" 실주행 테스트. 조이스틱 수집기(plan_20260518_joystick_data_collector.md)는 이미 있어 인프라 추가 비용은 없음. 나중 일(B 수준 추진 시): V5 바스켓 수집(60~150 에피소드, 9 path types) 규모를 객체별로 반복해야 함 — 수주 단위 투자. 지금 단계에서 착수할 근거(실제 멀티태스크 요구, 충분한 인력)가 갖춰질 때 별도 plan으로 분리.
38-4. "B 수준으로 가면 다를까" — 학습 없이 바로 측정 (hidden state 거리)
38-2의 질문("헤드 입력을 bbox 대신 PG2 hidden state로 바꾸면 다를까")을 재학습 없이 바로 확인했다.
scripts/measure_hidden_state_pg2.py — attention 가중치가 아니라
action head가 실제로 받을 표현(벡터) 자체가 instruction에 따라 얼마나 갈리는지, 코사인거리로 측정.
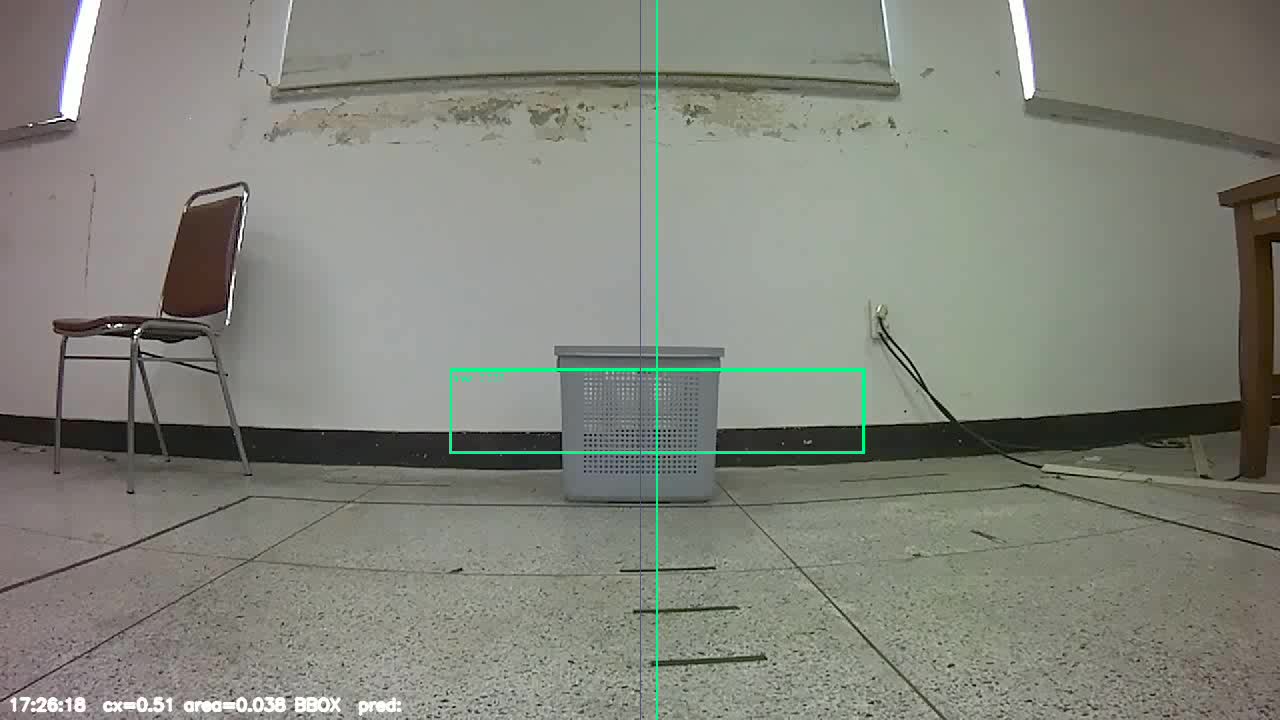 S6 baseline (f1)
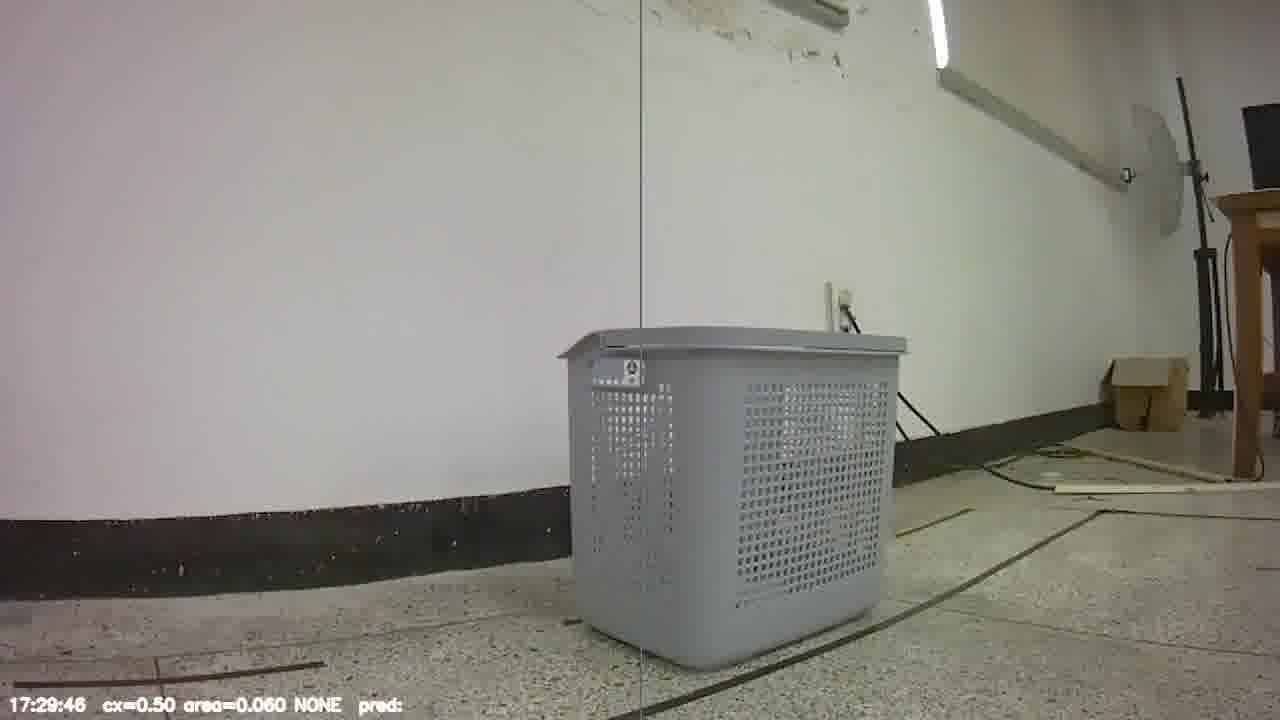 S6 dead-zone (f70)
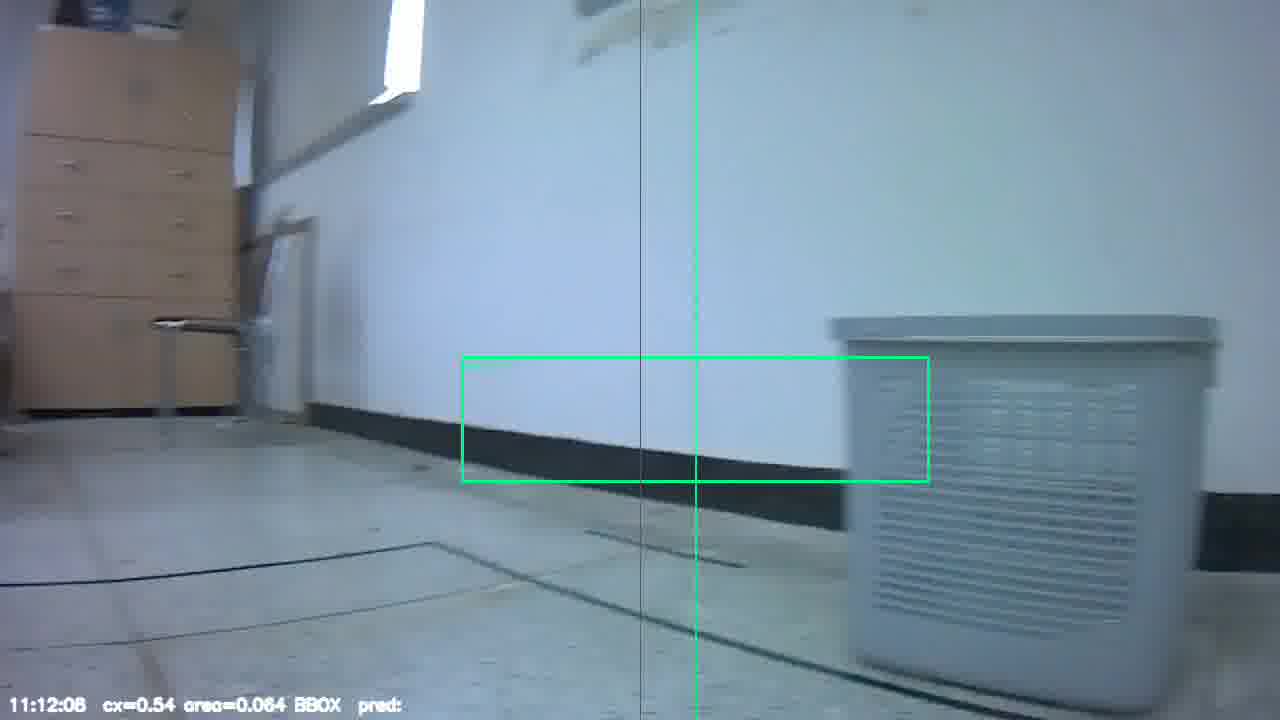 S7 정상검출 (f54)
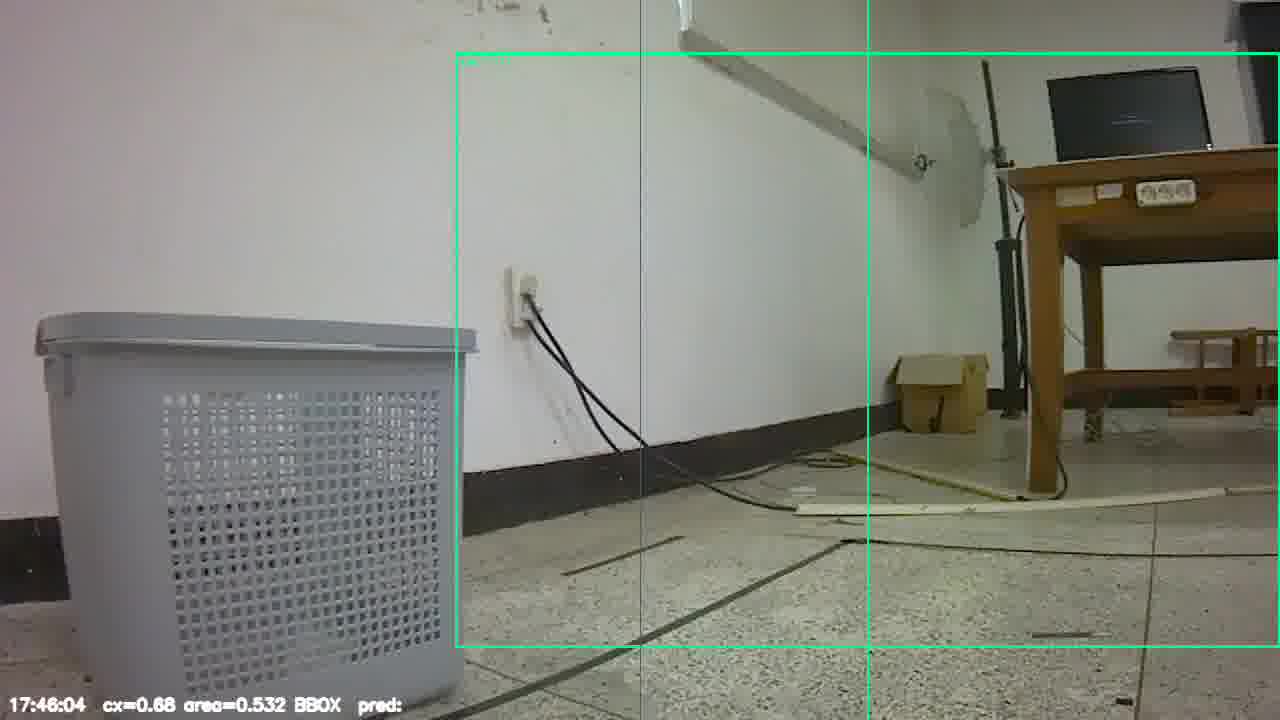 S8 production/mix-448 (f20)
비교cos_dist(이미지1)cos_dist(이미지2)의미
동일 prompt 반복(노이즈 바닥선)
0.00000
0.00000
deterministic, 완벽한 기준선
basket vs ball(객체 다름)
0.363
0.441
강한 신호 — 헤드가 학습하기 충분
left/right/forward(방향만 다름)
0.029~0.043
0.037~0.051
약하지만 0은 아님
객체차이/방향차이 비율
9.8x
10.2x
두 이미지에서 일관됨
결론: "B 수준(객체를 바꾸는 instruction)"으로 가면 hidden state 신호가 충분히 강해서 학습이 될 가능성이 높다 —
38-3의 멀티 객체 grounding 검증(5/5 hit)과 정확히 같은 방향의 증거가 표현 레벨에서도 나왔다.
반면 "방향/스타일을 바꾸는 instruction"은 신호가 객체 차이보다 10배 약해서, 같은 방식으로 헤드에 넣어도
Exp12/13처럼 학습이 잘 안 붙을 위험이 여전히 있다 — attention spread(1.4%p, CH2 박스)와 일관된 결론.
즉 B 수준을 "타겟 객체 전환"으로 한정하면 유망하고, "주행 스타일/방향 제어"까지 노리면 여전히 위험하다.
38-5. 정정 — 코사인거리만으론 안 와닿아서 실제 생성 출력으로 재확인
38-4의 cos_dist 수치는 추상적이라, PG2가 실제로 무엇을 생성하는지를 4개의 서로 다른 실제 바스켓 세션 사진
(S6 baseline·S6 dead-zone·S7 정상검출·S8 production/mix-448)에서 직접 확인했다 — 사진과 raw 출력은
today_visual_summary.html 6막에 전부 첨부.
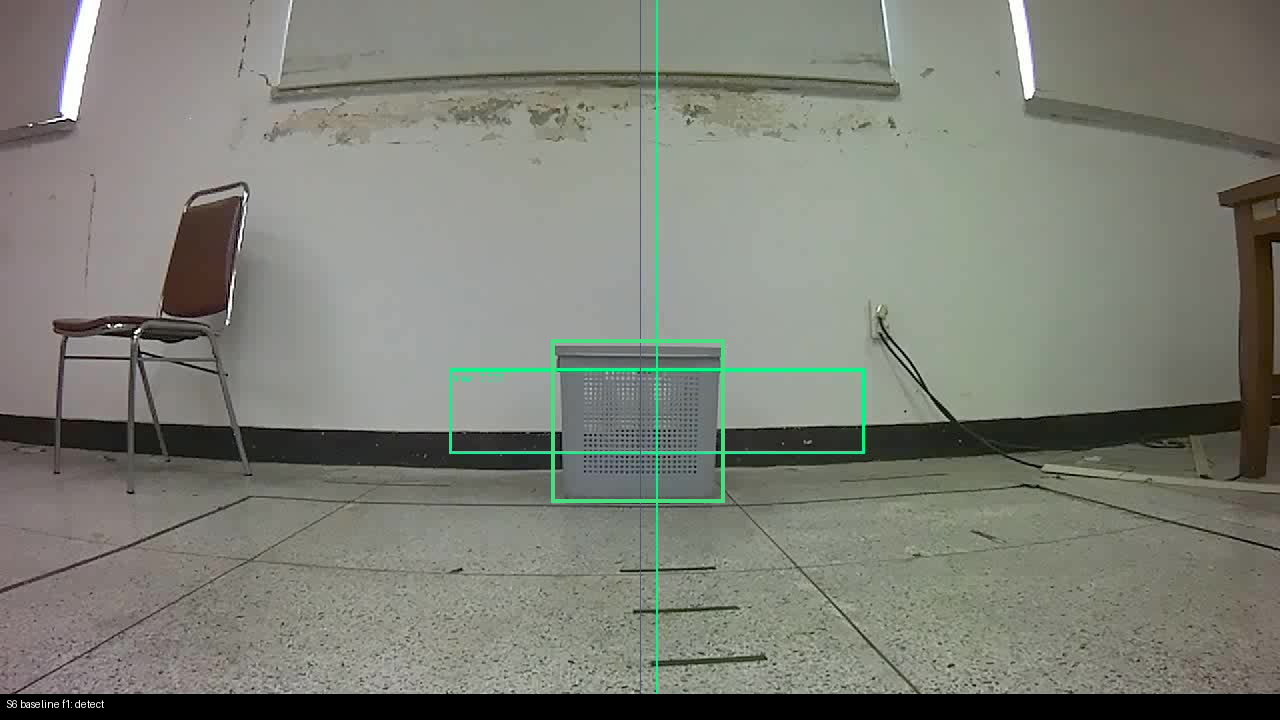 "detect gray basket" — S6, 박스=실제 출력 좌표
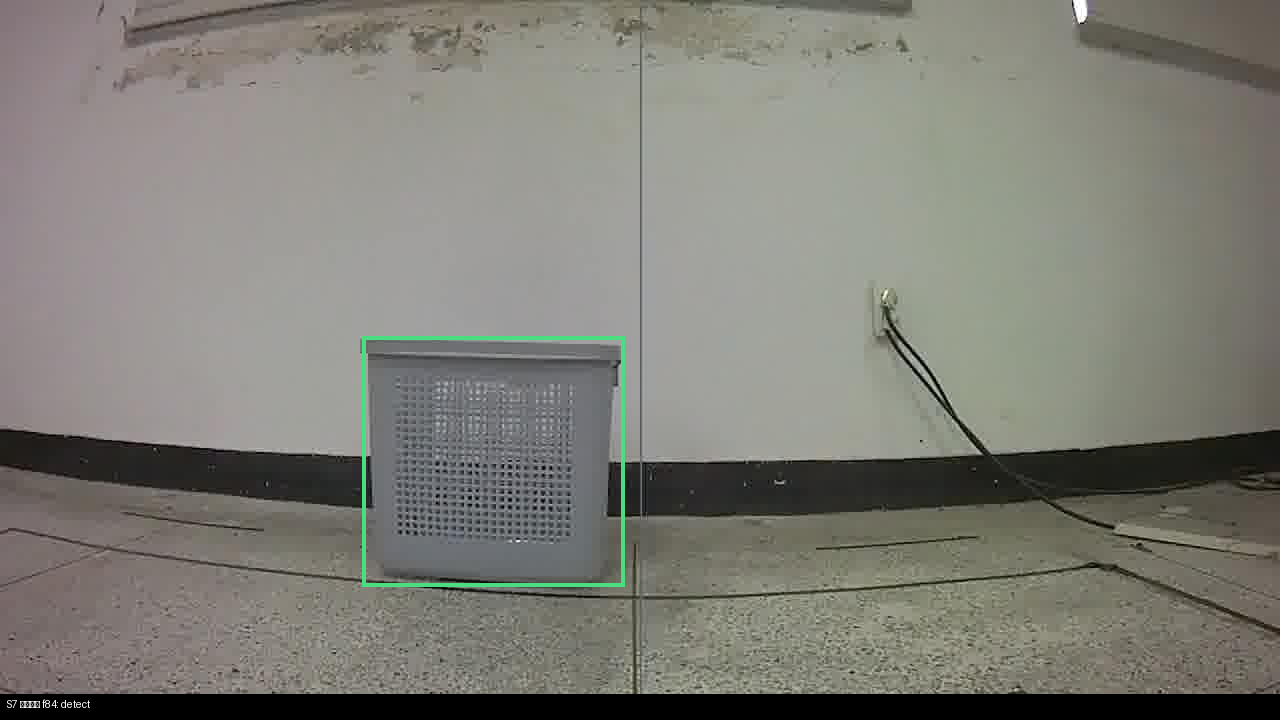 "detect gray basket" — S7, 타이트하게 정상 검출
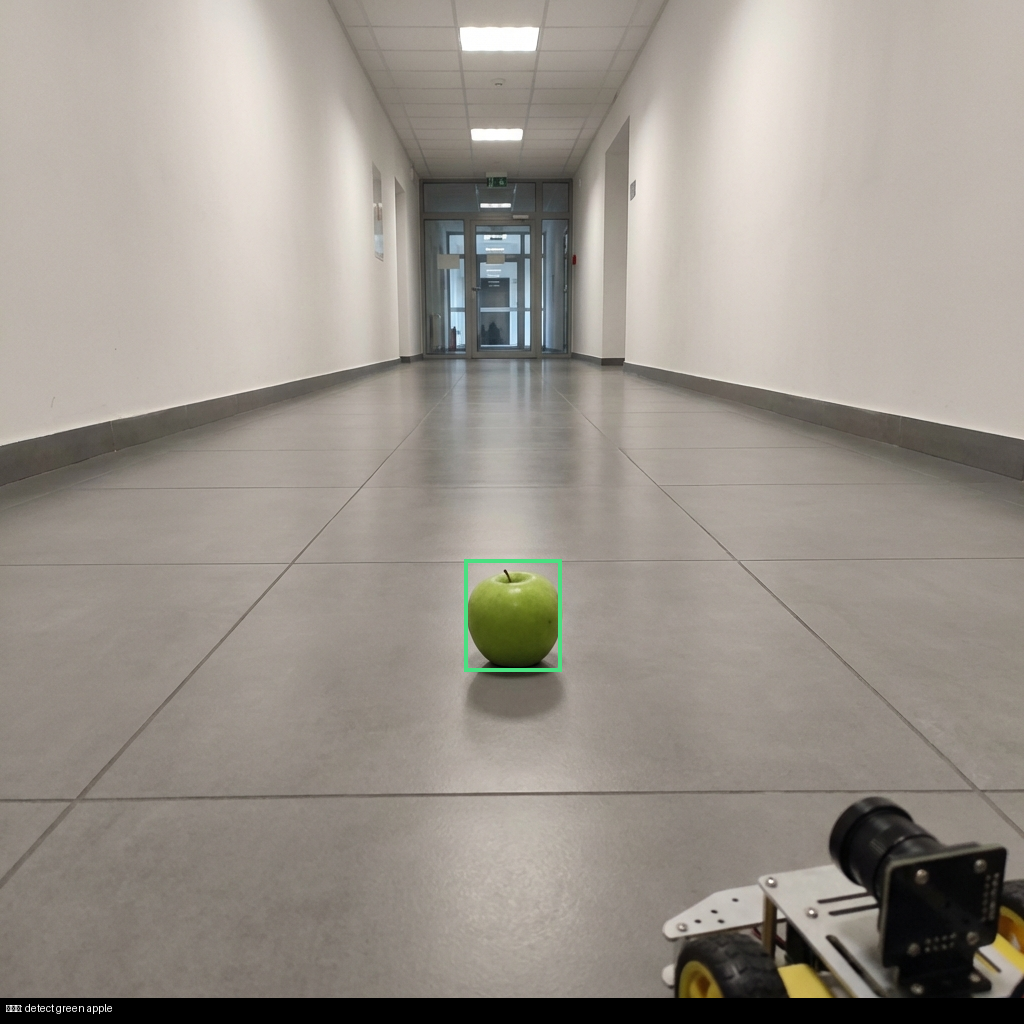 대조군: "detect green apple" — 박스가 사과를 정확히 잡음, 객체가 바뀌면 출력도 확실히 바뀜
프롬프트4개 세션 결과
"detect gray basket"
4개 전부 정상 bbox(세션마다 다른 좌표 — 실제 장면 반영)
"detect gray basket on the left/right"
4개 전부 bbox가 노이즈 수준(±1픽셀급)으로만 다름 — 방향 단어를 그냥 텍스트로 echo만 함
"Navigate to the left/right toward the gray basket"
4개 전부 'yes
CH38-5(생성 출력 레벨)와 CH39 Step B(이미지 신호)를 hidden-state 레벨에서 하나로 통합 — 같은 220장에 prompt만 바꿔서 비교
CH38-5는 "방향 텍스트를 줘도 생성 출력이 안 바뀐다"를 4장 사진으로 보였고, CH39 Step B는 "텍스트는 고정인데 이미지가 다르면 hidden state가 90%로 갈린다"를 220장으로 보였다. 이번엔 같은 220장에 prompt를 거짓 방향으로 고정해서 두 결과를 한 표로 합쳤다 — "이미지가 말하는 방향"과 "prompt가 우기는 방향" 중 어느 쪽이 hidden state를 더 강하게 결정하는가.
42-1. 이미지 신호가 거짓 prompt에도 안 흔들린다 — prompt 자체는 99%로 구분되지만 "이해"는 아니다
scripts/eval/probe_v5_direction_text_prompt.py — V5 220장 각각에 P0("detect gray basket")/ P1("...on the left")/P2("...on the right") 3가지 prompt로 hidden state를 추출(660회), frozen probe 4종 측정. proben_class5-fold CV accchance 대비 이미지 방향 vs P0(중립 prompt) 3 90.0% ± 3.1% 2.70x 이미지 방향 vs P1("on the left"로 고정) 3 92.3% ± 3.4% 2.77x 이미지 방향 vs P2("on the right"로 고정) 3 91.8% ± 3.1% 2.75x prompt 종류(P0/P1/P2) 자체 3 99.2% ± 0.5% 2.98x 결론: prompt가 거짓 방향("on the left")을 우겨도, 같은 이미지의 진짜 방향 인식 정확도는 90.0%→92.3%로 오히려 살짝 높다(노이즈 범위 내, 통계적으로 떨어지지 않았다는 게 핵심) — 이미지 신호가 prompt의 거짓 주장에 전혀 안 흔들린다. 반면 prompt 종류 자체는 99.2%로 거의 완벽히 구분되는데, 이건 "방향을 이해해서"가 아니라 단순히 다른 토큰 시퀀스라 hidden state가 다른 것(CH38-4의 cos_dist 0.03~0.05와 같은 맥락) — prompt 식별은 쉽지만 prompt가 명령하는 방향이 행동/표현에 반영되진 않는다. CH38-5(출력 레벨, 4장)와 CH39 Step B(이미지 레벨, 220장)를 하나로 합치면: "무엇을 보는가"는 이미지가 결정하고, "어느 쪽으로 가라는 지시"는 hidden state 차원에서도 사실상 도달하지 않는다는 게 더 큰 표본으로 재확인됐다.
42-2. 토큰 길이를 통제해도 같은 결론 — "gray"를 "left/right"로 1단어만 치환
42-1의 P1/P2는 P0보다 단어 수가 2배 길어서("on the left" 추가) "prompt 종류 99.2% 구분"이 방향 이해가 아니라 단순 길이 차이일 수 있다는 지적(사용자)이 있었다. 그래서 단어 수를 완전히 맞춘 버전으로 재실행했다 — P0="detect gray basket" / P1="detect left basket" / P2="detect right basket" (전부 3단어, "gray"만 "left/right"로 치환). probe5-fold CV acc 이미지 방향 vs P0("gray", 기존) 90.0% ± 3.1% 이미지 방향 vs P1("left"로 1단어 치환) 89.5% ± 4.0% 이미지 방향 vs P2("right"로 1단어 치환) 90.5% ± 3.6% prompt 종류(P0/P1/P2) 자체 99.5% ± 0.6% 결론: 길이를 완전히 맞춰도(단어 수 동일, 1단어만 다름) 결과는 그대로다 — 이미지 방향 인식은 89.5~90.5%로 안정적이고, prompt 종류 구분은 오히려 더 선명해졌다(99.5%). 즉 "단어 1개만 달라도 hidden state는 쉽게 구분하지만, 그 단어가 방향 단어("left"/"right")인지와 실제 이미지 방향 인식 사이엔 관계가 없다"는 걸 더 깨끗하게 확인 — 42-1의 결론이 길이 차이로 인한 착시가 아님이 재확인됐다. plans: plan_20260622_text_prompt_hidden_state_direction.md | 2026-06-22
7/6 OWL-v2(th=0.25) 실로봇 첫 배포에서 obj_left/right 반복 실패 → 원인 추적 도중 연구 재현 파이프라인의 치명적 버그 발견, 여러 결론이 정정됨 (2026-07-06~07)
61-1. 실로봇 실패 관측
obj_right(타겟 우측) 16개 에피소드 전부 실패(SR 0%), obj_left도 top액션이 오히려 반대방향(우측계열) 편향. 7/6 세션 h5 직접 분석 결과, cx가 0.75→0.94로 실제 우측 드리프트가 있었는데도 14프레임 전부 FORWARD 고정인 사례 확인 — 그라운딩 신호는 정상인데 헤드가 무시하는 패턴.
61-2. 그라운더 vs 헤드 — clean bbox 검증으로 헤드 무죄 확인
사람이 직접 라벨링한 bbox_truth_mini.json(72프레임/18ep)으로 "완전히 깨끗한 bbox를 주면 헤드가 맞게 예측하는가" 검증. 1차 시도(100%)는 18ep 중 15개가 학습셋에 포함된 오염으로 무효 판정 → truth_mini 완전 격리 후 재학습, 진짜 held-out으로 재검증: 구성val_acctruth_mini 진짜 held-out acc baseline_w6 97.0% 95.8% window3 94.8% 98.6% 헤드는 clean bbox에 대해 진짜로 일반화한다 — 문제는 헤드 구조/학습능력이 아니라 실전 입력 분포(flicker) 쪽으로 좁혀짐.
61-3. 진짜 병목 — 학습/실전 flicker 분포 불일치
exp71 실제 학습 데이터(bbox_dataset_pg448_cx.json) has_bbox=97.8%인데, soda 관측 실전 OWL-v2 세션은 has_bbox=False가 40~60% — 큰 분포 괴리. 상관형 flicker(근접 직후 집중 dropout) 주입 재학습: 변형val_acc진동율 baseline (w6) 98.4% 3.0% dropout_aug 97.1% 5.2% (최악) sticky_aug 98.1% 1.9% window3 98.7% 1.9% 단, 진짜 성공기준(FPE/SR/TLD, rollout_core 리플레이)으로 재확인하면 window3와 운영중인 window6이 사실상 동률(SR 97.7% 동일) — "진동율" 대리지표 기준 window3 우위 결론은 철회. 리플레이 자체가 카메라 피드백이 없는 근본적 한계라 더 이상 오프라인으로는 판별 불가.
61-4. 치명적 버그 — vis_feat L2-정규화 누락
운영 서버(Stage1Encoder.encode_image)는 이미지 feature를 F.normalize()로 L2 정규화하는데, 연구 재현 스크립트(train_exp71_stage2_transformer.py)는 정규화를 안 함. soda 실제 세션으로 검증한 재현 일치율: 세션정규화 없이정규화 후 233327 25.0% 91.7% 233424 11.1% 88.9% 이 세션에서 "진짜 exp71 레시피"라 진행했던 실험 다수가 이 버그 상태로 이뤄짐 — 발견 후 정규화 수정하여 재검증.
61-5. VLA 사다리 ② 언어조건화 재검증 — 버그 수정 후 결론이 더 강하게 부정적으로
비교군PM (43ep 프록시, 버그있음)PM (150ep 실제 레시피, 버그수정) no_text 78.4% 87.5% with_text 81.8% (+3.4%p) 85.0% (오히려 하락) Counterfactual 변화율: 43ep 실험 20.3% → 150ep 실제 레시피 정확히 0.0% — 왼쪽/오른쪽 지시를 강제로 바꿔도 예측이 단 하나도 안 바뀜. 텍스트를 참조는 하지만 (permutation −16.1%p) "명령"이 아니라 "경로 맥락(prior)"으로만 쓰인다는 결론이 버그 수정 후 오히려 더 명확해짐. 조이스틱 이질 지시 데이터 없이는 해결 불가로 재확인.
61-6. Vision encoder 비교 (PG2/SigLIP vs Kosmos-2) + 합성 이질지시 테스트
PG2(PaliGemma2-448) SigLIP vision tower(1152d)로 exp71 vision 소스를 교체해도 Kosmos-2와 대등(96.2% vs 97.0~98.4%, 1차 시도 73.4%는 다수클래스 붕괴였음을 확인 후 프로젝션 수정으로 정상화) — vision encoder 종류는 병목이 아님을 재확인. 실물 조이스틱 데이터 수집 전, 같은 프레임에 상충 지시+강제 라벨을 합성으로 넣어 counterfactual이 살아나는지 사전 테스트 — 변화율 0.3%→0.8%로 거의 안 살아남. 합성 라벨(이미지와 무관하게 고정)이 잡음처럼 취급된 것으로 추정, 실물 수집만이 확실한 다음 단계로 재확인.
61-7. obj_left/right/center 테스트는 학습 분포 밖(OOD) 스트레스 테스트였다
정정(path_type 명명): 첫 단어는 "로봇 시작위치"가 아니라 목표(바구니) 위치(좌/중/우), 두 번째 단어는 접근 경로의 곡선 방향(좌/직진/우) — mobile_vla_data_collector.py 원본 확인. 교수님 Step3 "33/33/33(left/straight/right)"은 경로곡선 축만 3분류한 커리큘럼. 아래 cx 실측 수치는 이 정정과 무관하게 유효. right_left(exp66 시절, 6/26, V5 9종 path_type 중 하나)는 34/34(100%) 성공 — in-distribution 테스트라 당연한 결과. 반면 obj_left/center/right(6/30~, 9종 path_type 어디에도 없는 별개 스트레스 테스트)는 3/8, 3/8, 0/26 — 그라운더/프리뷰 교체와 무관하게 애초에 다른(더 어려운) 테스트였음. CX_RULE_THRESHOLDS(서버 방향판정 5구간) 기준 학습 데이터 커버리지: 구간cx 범위학습 프레임 비율 ROT_L(강한좌) <0.25 1.8% FWD_L 0.25~0.40 15.9% FORWARD(중앙) 0.40~0.60 68.0% FWD_R 0.60~0.75 12.9% ROT_R(강한우)
0.75 1.4% 강한좌+강한우 합쳐 3.2%뿐. center_left/center_right는 이 구간을 단 한 프레임도 겪은 적 없음. obj_right가 요구하는 cx 0.9대 영역은 학습 데이터가 거의 커버 못 하는 지대 — "cx 0.9에서도 FORWARD 고정"의 근본 원인과 정합. 재학습보다 먼저 이 구간 데이터 자체를 확보해야 함.
61-9. 좌/우 비대칭 발견 + bbox_scale 대응 + soda 배포 (2026-07-07~08)
FWD+L recall 88.5%인데 FWD+R recall 67.6%(21.6%가 FORWARD로 오분류) — 극단 cx가 아닌 정상범위에서도 좌/우 비대칭 확인. class-weight(diag_mult)만으론 단일시드 표준편차 24~27%p로 극도로 불안정(같은 설정 재현 시 89.8%↔72.4% 널뛰기 확인). bbox_scale(bbox 4dim을 이미지feature 대비 상대적으로 키우는 것)이 훨씬 효과적 — 멀티시드(5) 비교: 조합val_acc진동율 window6+bbox1x(기존) 69.7%±4.7% 19.0%±4.3% window6+bbox3x 85.4%±2.3% 14.3%±7.2% window3+bbox3x 78.6%±4.4% 18.4%±3.0% window3+bbox3x+sticky_aug 80.2%±5.1% 21.2%±0.2%(악화) window6+bbox_scale3x가 정확도·진동율 둘 다 최고 — window을 줄이는 것(window3)보다 window은 그대로 두고 bbox 신호만 키우는 게 더 나은 것으로 재확인. sticky_aug는 bbox_scale 적용 후에도 여전히 무효. 배포 완료: 서버에 ckpt.get("bbox_scale",1.0) 하위호환 지원 추가 후, exp71_window3_bboxscale3(5-seed 80.7%±4.3%)와 exp71_window6_bboxscale3(5-seed 84.6%±2.9%, 최고 88.5%, 가장 유력 후보) 두 체크포인트 모두 soda 서버로 rsync 전송 완료 — 실로봇 3자 A/B(기존 window6 / window3+bboxscale3 / window6+bboxscale3) 대기 중.
61-11. soda 제기 BGR/RGB 의심 건 — 실물 대조로 기각 (2026-07-08)
soda가 mobile_vla_data_collector.py의 cv_bridge.compressed_imgmsg_to_cv2(...,"bgr8")로 받은 배열이 JPEG 인코딩 없이 H5 raw로 저장되는데, 학습 로더(nav_h5_dataset_impl.py)는 이를 RGB로 가정하고 읽는다는 의심을 제기 (241/241 에피소드 전부 raw 저장 확인 — 전수 영향권). 색 채널을 반전(BGR→RGB)해서 vis_feat 캐시 재생성 + window6+bbox_scale3 재학습까지 진행: 5-seed 79.6%±3.7% — 원본(반전 없음) 84.6%±2.9%와 유의미한 차이 없음. 결정적으로 사용자가 실제 촬영 공간을 직접 눈으로 대조한 결과, 현재 로더(반전 없음) 쪽이 실물 색에 더 가까움을 확인. 코드 추적(명시적 "bgr8" 요청, 중간 변환 없음)은 여전히 이론상 스왑 가능성을 가리키지만, 실물 대조라는 더 강한 증거 앞에서 기각 — 카메라 원본 인코딩이 이미 bgr8이라 반전이 사실상 무변환(no-op)이었을 가능성. 결론: 재학습 불필요, 어제 배포한 window6+bbox_scale3(원본) 그대로 유지. 색 반전판 체크포인트(exp71_window6_bboxscale3_colorfixed)는 참고용으로만 보존.
61-12. 조이스틱 재수집 설계 정정 — "지시-경로 디커플링" (2026-07-09)
이번 주 결론: 그라운더 수정, vis_feat 정규화 버그 수정, bbox_scale로 좌우비대칭 완화, PG2 비전인코더 비교 — 가능한 모델/학습 레벨 레버는 거의 다 당겨봤고, 남은 두 근본 원인은 코드로 해결 불가능: - 극단 cx(강한좌/우) 학습 데이터 자체가 3.2%뿐 — 입력 분포 커버리지 부족 (더 모으면 해결) - 텍스트-장면이 1:1 상관 — counterfactual changed_rate 정확히 0.0% — 라벨링 구조상 언어를 따르는 신호 자체가 데이터에 없음 (같은 방식으로 더 모아도 해결 안 됨) 수집 설계 정정: 타겟은 gray basket 하나뿐이라 "다른 목적지 지시" 분기는 불가능. 대신 바뀌는 축은 바구니까지 접근하는 경로 곡선(좌곡선/직진/우곡선)이며, 이 지시를 화면상 바구니 위치(cx)와의 결박을 끊고 매 회차 무작위 배정 — 같은 극단 cx 시작 장면에서 좌곡선 지시를 받은 에피소드와 우곡선 지시를 받은 에피소드가 모두 존재하게 되고, 오퍼레이터는 실제로 그 지시를 따라 조이스틱으로 다르게 주행 → 실제 궤적(라벨)이 갈라지는 진짜 counterfactual 쌍이 생성됨. 지시를 무시한 임의 주행은 금지(그러면 반대로 "지시=노이즈"라는 잘못된 신호를 학습시킴). 수집 인프라(대시보드 📷 데이터수집 탭)는 soda가 이미 구현 완료 — 남은 것은 이 디커플링 프로토콜을 적용한 실제 물리적 수집. 상세: plan_20260707_heterogeneous_instruction_extreme_cx_collection.md §1-1
61-13. obj_right에서 왜 하필 FWD+L이 반복됐나 — 세 번째 confound (2026-07-09)
실로봇 obj_right 실패에서 그라운딩(OWL-v2)은 정상 동작했는데 액션이 반복적으로
FWD+L로 나온 이유를 데이터셋에서 역추적.
bbox_dataset_pg448_cx.json에서 cx>0.6(화면 오른쪽) 프레임의 gt_class 분포:
FORWARD:259, FWD+L:67, RIGHT:29, ROT_L:20, FWD+R:19, ROT_R:3 — FWD+L(67개) 중
대부분이 path_type="right_left"(목표=우측, 접근 경로=좌곡선) 한 종류에 집중
(cx>0.6 구간의 68%, 55/81건이 gt_class=FWD+L).
원인: right_left는 "바구니는 오른쪽에 있지만 접근 경로 자체를 왼쪽으로 크게 돌아 들어가는"
시나리오라, 물체가 화면 오른쪽에 보이는 순간에도 정답 라벨이 FWD+L로 기록됨. 모델은 이 패턴을
정확히 학습했을 뿐 — CX_RULE_THRESHOLDS 룰 기반 오버라이드는 기본 꺼져있어(VLA_CX_RULE=0)
관여하지 않음, 순수 학습된 헤드의 정직한 예측.
세 번째 confound로 정리: ①극단cx 커버리지 부족, ②텍스트-장면 confound에 이어
"화면상 위치(cx)"와 "경로 곡선 방향"이 path_type 설계 단계에서 뒤섞여 있어서,
cx만으로는 목표 방향을 안정적으로 추론할 수 없는 구조. 61-12의 지시-경로 디커플링 수집으로
함께 해소될 것으로 기대.
61-14. 수집/학습 Hz 정합 + action chunking 검토 (2026-07-09)
현재 수집: on_command() 이벤트 트리거(명령 변경 시에만 프레임 기록), 실질 4~7Hz. 실추론 레이턴시는 450~600ms/frame(~2Hz). 문제는 window(3/6프레임)가 프레임 "개수" 기준이라, 조작 밀도에 따라 체감 시간폭이 최대 3배 이상 들쭉날쭉(촘촘한 조작 구간 ~0.85초 vs 성긴 구간 ~3초) — 추론 시 실제 시간폭(window=6 @ ~2Hz ≈ 3초)과 불일치. 타 VLA 비교: RT-1/RT-2(~1~3Hz, closed-loop), ViNT/NoMaD(~4Hz, 우리 수집 레이트와 가장 근접), π0/SmolVLA는 "느린 VLM 추론 + 빠른 실행"을 action chunking으로 구조적으로 분리(π0는 청크 내부 50Hz open-loop 실행, 재계획은 청크 단위로만). 결론: 수집 Hz(4~7Hz)는 그대로 유지(조작 해상도 보존). 대신 학습 window 구성 시 ~2Hz(500ms) 간격으로 리샘플링해서 추론 cadence와 시간폭을 정합 — 현재 액션헤드 구조를 유지한 채 적용 가능한 값싼 절충. 근본적으로는 action chunking 구조 도입을 별도 트랙으로 검토 (우선순위: 리샘플링 먼저 검증 → 부족 시 chunking 검토). 플랜 문서 §4에 두 항목 모두 추가.
61-15. 수집 플랜 트랙 분리 — 도달성능(A) vs 언어조건화(B) (2026-07-09)
질문: "목표(gray basket)에 다가가는 것만이 목표라면 지시-경로 디커플링(61-12)까지
할 필요가 있나?" — 정답은 아니오, 순수 도달 성능에는
불필요. 텍스트-장면 confound(②)는 목표가 하나뿐인 태스크에서는 실패 원인이
아니고, 실제 obj_ 실패의 직접 원인은 ①극단cx 부족과 ③cx-경로곡선 confound
(61-13, FWD+L 반복)뿐이기 때문.
그래서 수집 플랜을 두 트랙으로 분리:
- 트랙 A(핵심, 180ep): 극단cx 4곳 × 경로 다양성, 지시문 불필요 —
오퍼레이터가 같은 위치에서 자유롭게 다른 경로로 여러 번 주행. obj_ 도달성능 직결.
- 트랙 B(선택, 60ep): 지시-경로 디커플링(61-12) — 언어조건화
로드맵 대비용으로 격을 낮춰 "수집 세트 중 하나"로 포함, 트랙A 대비 후순위.
재확인된 결론: 어느 트랙이든 현재 150ep
데이터셋만으로는(학습 기법을 뭘 써도) 해결 불가 — 이번 주 시도한 모든 학습레벨
우회(정규화 수정, bbox_scale, PG2 교체, synthetic augmentation)가 이미 한계에 도달했고,
근본 원인이 데이터에 신호 자체가 없는 것이라 재수집이 유일한 해법.
soda 쪽에서도 이미 같은 방향(4-position 극단 배치 수집 UI)을 대시보드에 구현 중
(930a6180 cx-axis 진행률 차트, 984b0ae4 조이스틱 D-pad 시나리오 전환).
상세: plan_20260707_heterogeneous_instruction_extreme_cx_collection.md §0,§1
61-16. 재수집 전 마지막 완화책 3종 실측 — 전부 무효 확인 (2026-07-10)
재수집 없이 현재 150ep로 짜낼 수 있는 마지막 학습레벨 시도를 window6+bbox_scale3 (현재 배포 baseline) 기준 5-seed로 비교 — scripts/train_exp71_confound_mitigation.py. 설정val_accFWD+L recallcx>0.75 acc(n=2)cx<0.25 acc(n=10) A. 현재 배포(baseline) 76.0%±4.5% 0.78 1.00 0.44 B. confound reweight(right_left 모순라벨 downweight) 75.2%±5.1% 0.63↓ 1.00 0.42 C. hybrid cx-rule 오버레이(극단cx만 기하규칙 덮어쓰기) 74.2%±4.4% 0.78 0.00 0.00 B: 의도대로 FWD+L 과확신은 줄였지만(recall 0.78→0.63), 전체 정확도만 살짝 깎이고 극단cx 구간 개선으로 이어지지 않음 — 그 구간엔 애초에 "맞는 방향" 대안 신호 자체가 없어서 downweight해도 대체할 게 없음. C: 오히려 완전히 악화(0%) — 서버의 CX_RULE_THRESHOLDS가 가정하는 "cx>0.75→ROT_R"이 현재 데이터 라벨과 실제로 안 맞음(그런 기하학적 가정 없이 수집됐기 때문). 극단cx 라벨 자체가 기하학적으로 일관되지 않다는 것을 보여주는 직접적 증거. (cx 서브셋 n=2/n=10은 표본이 작아 절대수치는 신뢰 낮지만, 방향성 — 어느 것도 개선 안 됨, C는 명백 악화 — 은 결론을 뒷받침하기 충분함) 결론: "재수집 없이는 안 된다"가 이론이 아니라 실측으로 재확인됨. 배포된 window6+bbox_scale3(baseline) 그대로 유지 — 어떤 학습레벨 트릭도 도움 안 됨.
61-17. window3+bbox_scale3 배포 후 obj_right 실측 — 병목이 confound에서 그라운딩으로 이동 (2026-07-10/11)
soda 로봇에서 window3+bbox_scale3(val_acc 84.4%) 체크포인트로 obj_right 30회 실주행(episode_log.csv row 79~108) 결과: 구분성공/전체성공률 전체 17/30 56.7% OWL-v2 그라운딩 성공(실제 bbox 검출) 16/18 88.9% 그라운딩 실패(폴백 cx=0.5,area=0.06) 1/12 8.3% 이전 세션들(§7~15, window6 체크포인트 기준)에서는 obj_right 성공률이 0%였고 원인이 주로 FWD+L 반복(confound) 자체였다. 이번엔 그 confound가 사실상 해소된 채로(top액션이 거의 전부 FORWARD로 수렴) 그라운딩 성공 케이스에서 88.9%라는 높은 성공률이 나왔고, 실패 13건 중 10건은 "OWL-v2가 바구니를 못 찾아 중심좌표로 폴백"한 케이스였다. 의미: 실주행 핵심은 그라운딩/인식 개선이라는 가설이 실측으로 뒷받침됨. 트랙A(극단cx) 재수집과 별개로, OWL-v2 그라운딩 실패율 자체를 낮추는 것(임계값 튜닝, multi_prompt 폴백, 재시도 전략)이 지금 시점에서 성공률을 가장 빠르게 올릴 수 있는 지렛대로 보임. 세션 뷰어(mona_dashboard.py Session History 탭)에 이 분석을 세션별로 바로 볼 수 있도록 episode_log.csv 조인(실주행 결과/메모/FPE 배지)을 추가함 — 기존엔 H5 attrs 원본 텍스트만 노출되어 오퍼레이터가 남긴 성공/실패 메모가 묻혀 있었음.
61-18. 전체 108개 세션 시계열 종합분석 — 그라운더 교체는 무효, 체크포인트 교체가 유일한 변곡점 (2026-07-11)
episode_log.csv 누적본(108행, 2026-06-26~07-10) 전체를 path_type·날짜· 그라운더·체크포인트 축으로 교차분석. in-dist 시나리오(right_left, center_straight — 100% 성공)는 제외하고 OOD인 obj_ 계열만 봄(n=72). path_type성공률평균 레이턴시 obj_right 17/56 = 30.4% 1731ms obj_left 3/8 = 37.5% 1712ms obj_center 3/8 = 37.5% 886ms 날짜성공률그라운더체크포인트 06-30 3/6=50.0% PG2-448 window6 07-01 0/1=0% PG2-448 window6 07-02 3/21=14.3% PG2-448 window6 07-03 0/2=0% PG2-448 window6 07-06 0/12=0% OWL-v2로 교체 window6(그대로) 07-10 17/30=56.7% OWL-v2(그대로) window3+bboxscale3로 교체 핵심 발견: 그라운더를 PG2-448→OWL-v2로 교체한 07-06 시점엔 obj_ 성공률에 전혀 변화가 없었다(0%→0%). 체크포인트를 교체한 07-10에야 비로소 개선이 나타남. 즉 61-17의 "그라운딩 성공/실패가 성공률을 가른다"는 결론은 07-10 배치 안에서는 맞지만, 더 긴 시계열로 보면 체크포인트 교체가 그라운더 교체보다 훨씬 크게 기여한다 — 두 결론은 상충하지 않고 시간축으로 포개진다(체크포인트가 나쁘면 그라운딩이 잘 돼도 액션이 틀리고, 체크포인트가 좋아진 뒤에야 그라운딩 실패가 남은 병목으로 드러남). 실패 49건 메모 분류(전체 108건 기준): 그라운딩/인식 실패 13, 방향 반전/엇나감 8, 제자리 회전(웜업 이상) 5, 프리뷰 관련 오류 4, 직진 고착 1, 메모없음/기타 18. FPE는 성공 평균 0.031m vs 실패 평균 0.638m로 라벨링과 잘 정합됨. 의미: obj_*(극단cx) 계열은 그라운더가 바뀌어도 체크포인트가 바뀌어도 전체 기간 평균 34.7%(25/72)를 벗어나지 못함 — 트랙A(극단cx 재수집) 필요성이 시계열 전체로 재확인됨. preview/hint_cx/multi_prompt 등은 이 기간 내내 체크포인트 교체와 lockstep으로 같이 바뀌어서 개별 효과를 이 데이터로는 분리 불가 — 향후 같은 체크포인트 고정 상태로 토글만 바꾸는 A/B 필요.
61-10. 종합 결론 및 다음 단계
1) 그라운더(OWL-v2)는 무죄에 가까움 — clean bbox 검증에서 헤드 일반화力 확인 2) 진짜 병목은 (a) flicker 분포 불일치, (b) 언어 미조건화, (c) obj_* 테스트 자체가 학습 분포 밖(강한좌/우 구간 3.2%뿐), (d) bbox 신호가 이미지feature 대비 너무 약함(bbox_scale로 해결) 3) 오프라인 리플레이 방법론은 한계 도달 — 실로봇 A/B가 유일하게 남은 확정적 검증 4) 다음 우선순위: (a) 실로봇 3자 A/B(기존/window3+bboxscale3/window6+bboxscale3), (b) 조이스틱 이질 지시 + 강한좌/우 구간 데이터 수집(120ep, 대시보드 새 탭으로 준비 완료), (c) 프리뷰 옵션 D 로깅 배포 완료 — 다음 세션에서 실측 축적 전체 상세: CH61_OWL_LIVE_FAILURE_AND_FIX.md | 프리뷰 재설계 플랜: plan_20260706_preview_redesign.md | 조이스틱 수집 플랜: plan_20260707_heterogeneous_instruction_extreme_cx_collection.md
FUTURE WORK · 현재 시스템은 언어가 고정 상수라 엄밀히 VLA가 아니다(CH65, 모델 구조 1-2절). 교수님이 말씀하신 "지시문에 따라 액션이 달라지는 VLA"로 가려면 무엇이 필요한지, 그리고 과거 시도가 왜 증명이 되지 못했는지를 정리한다.
🟣 3줄 요약 ① 과거 지시문 조건화 실험은 라벨 누출이었다 — 지시문을 path_type에서 합성해 "curve to the left"가 정답 클래스를 직접 지시했다. permutation drop 14.6%p는 언어 이해가 아니다. ② 진짜 증명에는 "언어 없이는 풀 수 없는 과제"가 필요하다 — 같은 장면·같은 초기 프레임에서 지시문만 바꿔 다른 타겟으로 가야 한다. ③ 가장 싼 경로는 이미 열려 있다 — OWL-v2가 open-vocabulary라 지시문에서 타겟 명사만 파싱해 프롬프트로 넘기면 검출 대상이 바뀌고, cx가 바뀌고, 액션이 바뀐다.
🚫 68-1. 과거 시도의 재해석 — 성공처럼 보였지만 라벨 누출이었다
scripts/train_step2_instr_head.py로 이미 지시문 조건화를 실험한 이력이 있고, 방법론은 훌륭했다 — shuffled 대조군, permutation 검정, counterfactual 검정을 모두 갖췄다. 결과도 긍정적으로 보였다: 조건PM (5 seeds) none (텍스트 없음) 78.35% ± 1.67% real (실제 지시문) 81.77% ± 1.01% shuffled (무작위 교환) 77.47% ± 1.68% permutation drop 80.4% → 65.8% (−14.6%p) real > none > shuffled이고 permutation drop이 14.6%p — 표면적으로는 "모델이 지시문을 실제로 쓴다"는 강한 증거다. 그런데 지시문이 어떻게 만들어졌는지를 보면 결론이 뒤집힌다 INSTRUCTIONS = { "center_left": "the basket is ahead, curve to the left side to reach it", "center_right": "the basket is ahead, curve to the right side to reach it", "left_left": "the basket is on your left, curve left to reach it", ... # 9개 path_type 각각에 대응 지시문이 path_type에서 합성됐고, "curve to the left"는 정답 클래스(LEFT 계열)를 자연어로 직접 지시한다. 즉 모델은 언어를 이해한 것이 아니라 정답을 텍스트로 받은 것이다. permutation drop 14.6%p는 라벨을 섞으면 정확도가 떨어진다는 자명한 결과이므로 언어 이해의 증거가 될 수 없다. 이 실험은 언어 조건화를 증명하지 못했다. counterfactual 결과도 사실 약했다 — 같은 프레임에 left/right 지시문을 주었을 때: 지시문→ 좌 클래스→ 우 클래스차이 left 지시 23.4% 19.6% +3.8%p right 지시 18.4% 20.3% +1.9%p 예측이 바뀌는 비율은 20.3%인데, 바뀌는 방향이 지시문과 일치하는 정도는 3.8%p / 1.9%p로 미약하다. "지시문에 반응하지만 올바른 방향으로 반응하지는 않는다." ※ 별개로 Kosmos-2 backbone 내부 언어 경로는 text attention 0.000%로 붕괴돼 있다(Exp17~41C, head-only에서도 재현). 위 실험은 그 경로를 우회해 OWL-v2 텍스트 인코더 임베딩을 헤드에 concat한 것이므로 두 사안은 층위가 다르다.
68-2. 무엇이 필요한가 — "언어 없이는 풀 수 없는 과제"
68-1의 교훈은 명확하다. 지시문이 정답과 상관되면 어떤 검정도 증명이 되지 못한다. 따라서 과제 자체를 바꿔야 한다. 현재 과제의 구조적 한계: 장면에 회색 바구니 하나뿐이다. 목표가 유일하면 지시문이 전달할 정보가 없다 — "바구니로 가"는 아무것도 추가하지 않는다. 그래서 지금 구조에서는 언어를 넣어도 파라미터만 늘어난다. 필요 조건: 같은 장면 · 같은 초기 프레임 · 다른 지시문 → 다른 타겟 장면: 왼쪽에 의자, 오른쪽에 바구니 지시문 A: "go to the chair" → 좌회전 궤적 지시문 B: "go to the basket" → 우회전 궤적 → 초기 프레임이 픽셀 단위로 동일한데 정답 액션이 반대다. 비전만으로는 원리적으로 풀 수 없으므로, 성능이 나오면 그것이 곧 언어 기여다. 이 설계의 결정적 장점 — 지시문이 타겟을 지정할 뿐 액션을 지시하지 않는다. 68-1의 "curve to the left"와 달리 "go to the chair"는 좌/우를 말하지 않으므로 라벨 누출이 원천적으로 불가능하다. 좌회전해야 한다는 것은 의자가 왼쪽에 있다는 시각 정보와 결합해서만 도출된다. 이미 보유한 자산 자산규모용도 V6 basket 데이터 225 ep 단일 타겟 baseline v5_2 chair 데이터 59 ep 2번째 객체 — 다만 chair가 장애물로 쓰인 것이라 타겟 궤적은 별도 확인 필요 CH30 의자 검출 검증 11장 detect chair 91% 검출 · 색 수식어 제거가 유리 OWL-v2 open-vocabulary — 프롬프트만 바꾸면 임의 객체 검출 Florence-2 언어부 140.2M CH67 67-2에서 비전부는 검증됨. 언어부는 미검정 instr 조건화 코드 — train_step2_instr_head.py — 검정 프로토콜 재사용 가능
🪜 68-3. 단계적 전환 계획 — L0에서 L3까지
각 단계는 "언어가 실제로 기여했는가"를 판정할 수 있는 최소 실험 단위로 끊었다. 앞 단계가 통과하지 못하면 다음으로 가지 않는다. 단계내용데이터로봇통과 기준 L0 현재 — 언어 무시(고정 상수) 보유 — baseline. 실기 89% L1 지시문 → 검출 대상 변경 지시문에서 타겟 명사를 파싱해 OWL-v2 프롬프트로 전달 불필요 ❌ 같은 프레임에 "chair"/"basket"을 주면 cx가 다르게 나오는가 L2 다중 객체 데이터 수집 의자·바구니 동시 배치, 지시문별로 다른 타겟 주행 신규 필요 ✅ 같은 초기 프레임에 서로 다른 정답 액션 쌍이 확보되는가 L3 언어 조건화 헤드 학습·검정 L2 산출물 ❌(학습) shuffled 대조군 대비 유의한 개선 + counterfactual 방향 일치율 L4 속성·관계 표현 ("왼쪽 바구니", "의자 옆 바구니") 추가 필요 ✅ 장기 과제. L3 통과 후 판단 L1이 핵심이다 — 지금 구조로 거의 공짜로 된다 OWL-v2는 open-vocabulary 검출기다. 현재 프롬프트 "gray basket"이 코드에 고정돼 있을 뿐, 지시문에서 타겟 명사를 뽑아 넘기면 검출 대상이 바뀐다. 그러면 cx가 바뀌고 → 액션 헤드 입력이 바뀌고 → 액션이 달라진다. 즉 "지시문에 따라 액션이 달라지는" 데모는 학습 없이도 만들 수 있다. CH30에서 detect chair가 91% 검출됨을 이미 확인했고, 코드 변경은 phrase 인자를 고정값에서 요청 파라미터로 바꾸는 수준이다 (OwlV2Grounder.run(phrase=...)은 이미 인자를 받는다). 단 한계를 정확히 말해야 한다 — 이건 언어가 "검출 대상"을 고르는 것이고, 액션 정책 자체가 언어에 조건화된 것은 아니다. 액션 헤드는 여전히 cx·비전만 본다. 논문에서 "language-conditioned policy"라고 주장하려면 L3이 필요하다. L1은 "language-directed target selection" 정도로 서술하는 것이 정확하다. L2 수집 설계 — counterfactual 쌍이 필수 - 같은 배치·같은 시작 자세에서 타겟만 바꿔 2회 주행 → 초기 프레임이 거의 동일한 쌍이 만들어진다 - 이 쌍이 있어야 "비전은 같은데 액션이 다르다"를 데이터로 보일 수 있다. 없으면 L3 검정이 성립하지 않는다 - 좌/우 배치를 교차시킨다(의자 좌·바구니 우 / 의자 우·바구니 좌) — 안 그러면 "의자=왼쪽"을 외워버려 언어 없이도 풀린다 - 규모 추정: 2객체 × 2배치(좌우 교차) × 2지시문 × 15회 = 60 ep가 최소선. CH66의 교훈대로 좌우 액션 클래스 균형을 수집 단계에서 관리
68-4. 검정 프로토콜 — 사전 고정 (라벨 누출 재발 방지)
68-1의 실패를 반복하지 않으려면 착수 전에 다음을 고정해야 한다. ① 지시문 작성 규칙 — 액션 어휘 금지 금지허용 "curve to the left" "go straight" "turn right to reach it" "go to the chair" "reach the basket" "move toward the gray basket" 지시문에 방향·동작 어휘가 들어가면 그 순간 라벨 누출이다. 타겟 명사만 허용한다. 검토 절차로 지시문 어휘 목록을 사전에 확정하고 left/right/straight/turn/curve 계열을 자동 검사로 차단한다. ② 필수 대조군 3종 - no_text — 언어 입력 없음. 하한선 - shuffled_text — 에피소드 간 지시문 무작위 교환. real ≈ shuffled면 언어를 무시하는 것 - wrong_text — 장면에 없는 객체를 지시("go to the table"). 모델이 혼란을 보여야 정상이다. 성능이 유지되면 언어를 안 읽는 것 ③ 주 지표 — counterfactual 방향 일치율 같은 프레임에 타겟 A/B 지시문을 각각 주고, 예측 액션이 해당 타겟 방향으로 갈라지는 비율을 재다. 68-1에서는 이 값이 3.8%p / 1.9%p로 미약했다. 이 지표를 주 지표로 삼고, 전체 정확도는 부지표로 둔다 — 정확도는 라벨 누출로 쉽게 올라가지만 방향 일치율은 그렇지 않다. ④ 실기 판정 — 최종 판정은 100건 실기 프로토콜을 따른다(CH64 64-18 기준). offline 지표는 사전 필터로만 쓴다. 이 세션에서 offline이 실기를 반복적으로 잘못 예측했다 (64-11 철회, 65-1 강우 반례). 다중 객체 과제의 실기 프로토콜은 "지시문별 성공률"과 "엉뚱한 객체로 간 비율(오타겟률)"을 분리해 보고한다 — 후자가 언어 실패의 직접 지표다.
68-5. 아키텍처 후보와 미해결 질문
언어를 어디로 주입하는가 경로방식평가 A. 검출 프롬프트 (L1) 지시문 → 타겟 명사 → OWL-v2 프롬프트 가장 싸고 즉시 가능. 단 정책 조건화는 아님 B. 헤드 concat (L3) 텍스트 임베딩(512d)을 260-dim 특징에 붙임 68-1이 쓴 방식. 코드 존재. 과제만 바꾸면 재사용 가능 C. cross-attention 텍스트 토큰에 헤드가 attend 표현력은 높지만 파라미터·데이터 요구 증가. 225ep 규모에서 위험 D. VLM 내부 언어 경로 Kosmos-2/Florence-2 언어부를 그대로 사용 Kosmos-2는 text attention 0%로 불가. Florence-2 언어부(140.2M)는 미검정 권고: A로 데모를 만들고, B로 정책 조건화를 검정한다. C는 데이터 규모가 확보된 뒤(CH67 67-3 ②와 같은 조건) 검토한다. 미해결 질문 4개 — 답이 없으면 진행 순서가 흔들린다 - Florence-2 언어부가 쓸 만한가? 비전부는 CH67에서 검증됐지만(cx MAE 0.0015, 파라미터 3.4배↓) 언어부 140.2M은 측정하지 않았다. 텍스트 임베딩 품질을 먼저 재야 B의 백본을 정할 수 있다 - 새 객체에 액션 헤드가 전이되는가? 헤드는 비전 피처 256-dim에 의존하고, 그 피처는 장면 외형을 담는다. 의자로 바꾸면 재학습이 필요할 가능성이 높다 — L2 수집 규모를 정하려면 이 답이 필요 - 단일 객체 성능을 잃지 않는가? 다중 객체로 확장하면 현재 89%가 떨어질 수 있다. 다중 과제 학습의 간섭을 측정해야 한다 - has_bbox 문제가 악화되는가? 지시문이 장면에 없는 객체를 지시하면 미검출이 정상 동작이다. 그런데 CH65 65-6에서 확인했듯 모델은 미검출 상황을 학습한 적이 없다(negative 0건). 언어 조건화는 이 문제를 필연적으로 키운다 — "없는 것을 찾으라"는 요청이 정상 입력이 되기 때문이다 CH67과의 관계 — 67-3 ③에서 "언어를 넣어서 무엇이 좋아지는가를 먼저 정량화해야 한다"고 적었다. CH68이 그 답이며, 결론은 "현재 과제로는 정량화 불가. 다중 객체 과제로 바꿔야 언어의 기여를 측정할 수 있다"이다.
68-6. 정리 — Future Work 우선순위
순위항목로봇비용얻는 것 1 L1 — 지시문 → 검출 프롬프트 ❌ 매우 낮음 "지시문에 따라 타겟이 달라지는" 데모. 코드 수정 불필요 — 이미 구현되어 있음 2 Florence-2 언어부 검정 ❌ 낮음 B 경로의 백본 결정. 68-5 질문 ① 3 객체 전이 실험 (기존 chair 59ep 활용) ❌ 낮음 L2 수집 규모 산정. 68-5 질문 ② 4 L2 — 다중 객체 counterfactual 수집 (~60ep) ✅ 중간 L3의 전제. 좌우 교차 배치 필수 5 L3 — 언어 조건화 헤드 학습·검정 ❌(학습) 중간 "language-conditioned policy" 주장의 근거 6 L3 실기 100건 검정 ✅ 높음 최종 판정. 지시문별 성공률 + 오타겟률 1~3번은 로봇 없이 가능하고 비용이 낮다. ⚠️ 정정 (2026-08-05) — 처음 이 표를 쓸 때 L1을 "코드 한 곳 수정"이라고 적었는데, 서버 코드를 확인하니 이미 구현되어 있다: stage2_v2_inference_server.py:1033 phrase = "gray basket" if instruction == "basket" else instruction → :1128 self.grounder.run(image_rgb, phrase=phrase) 요청의 instruction 필드가 그대로 OWL-v2 텍스트 쿼리로 전달된다. 즉 L1은 "구현할 것"이 아니라 "측정한 적이 없는 것"이다 → 68-7에서 측정했다. 다만 이것을 "language-conditioned policy"로 부르지 않도록 68-3의 용어 구분을 지킨다. 이 챕터의 성격 — 68-1 (과거 실험 재해석)과 68-7(L1 실측)은 완료된 측정이고, 나머지(68-2~68-6)는 미실행 계획이다. 논문 본문 주장으로 인용하지 않는다. 검정 프로토콜(68-4)을 착수 전에 고정한 것은 68-1에서 라벨 누출로 헛된 결론을 낸 이력과, 이번 세션에서 사후 해석으로 두 번 정정한 이력(64-11, 64-19) 때문이다.
68-7. L1 실측 — 같은 프레임, 지시문만 바꾸면 타겟이 바뀌는가 ✅
68-3의 L1을 실제로 측정했다. 68-6 정정에서 밝힌 대로 L1은 이미 구현되어 있으므로, 남은 건 구현이 아니라 측정이었다. 설계 — V6 val 프레임 200장에 대해 이미지는 완전히 동일하게 두고 OWL-v2의 텍스트 쿼리만 교체한다 (thresh 0.25, 서빙 필터 미적용 — 목적이 서빙 재현이 아니라 "텍스트가 타겟을 바꾸는가"이므로 최고점 박스를 그대로 본다). 핵심 지표는 사전에 조향 부호 반전율(sign(cx−0.5)가 지시문에 따라 뒤집히는 비율)로 고정했다 — 방향이 실제로 갈리는지가 최소 조건이기 때문이다. 지시문(phrase)검출률cx 평균score 중앙공통n|Δcx| 평균조향부호 반전율 "gray basket" (배포값) 91.0% 0.484 0.601 — — 기준 "chair" 35.5% 0.089 0.536 69 0.407 55.1% "door" 5.5% 0.131 0.305 11 0.433 72.7% "person" 0.0% — — 0 — 평가불가 "microwave oven" (부재 대조군) 5.0% 0.899 0.267 10 0.512 90.0% 결과 — 지시문이 타겟과 조향 방향을 실제로 바꾼다 같은 이미지에서 "gray basket" → cx 0.484 (중앙), "chair" → cx 0.089 (화면 좌측 끝)이고, 둘 다 검출된 69프레임에서 |Δcx| 0.407, 조향 부호가 55.1%에서 반대로 뒤집힌다. → 사전 고정한 판정 기준을 통과했다: language-directed target selection 성립. 추가 학습도 코드 수정도 없이, 요청의 instruction 필드만 바꿔서 얻은 결과다. ⚠️ 과대해석 금지 — 4가지 ① policy가 아니다. 액션 헤드는 여전히 cx·비전만 받고 텍스트를 보지 않는다. 바뀐 것은 헤드에 들어가는 cx이지 헤드의 동작이 아니다. 68-3 용어 구분대로 "language-conditioned policy"라고 쓰면 안 된다. ② 액션 클래스 변화는 측정하지 않았다. 헤드 입력이 6프레임 윈도우라 단일 프레임 교체로 재구성되지 않는다. 여기서는 조향 부호까지만 확인했다. ③ 반전율 55.1%가 과제 난이도를 반영하지 않는다. chair의 cx가 0.089±0.056으로 거의 항상 좌측 끝에 고정돼 있다 — 연구실에 정적인 의자가 한쪽에 있다는 뜻이다. 즉 "지시문에 따라 방향이 갈린다"는 성립하지만, 모델이 지시문과 장면을 결합해 추론했다기보다 서로 다른 고정 물체를 각각 찾은 것에 가깝다. L2의 좌우 교차 배치 요구(68-3)가 바로 이 문제를 겨냥한다. ④ 부재 판정이 완전하지 않다. 없는 물체("microwave oven")를 5.0%에서 검출했다. 낮지만 0이 아니고, 그 cx가 0.899로 화면 우측 끝에 몰려 있다(score 중앙 0.267 — 임계 바로 위). 즉 "없다"고 답하지 못하는 경로가 남아 있다. 이는 65-6·64-15의 has_bbox 문제와 같은 뿌리이고, 언어 조건화는 "없는 것을 찾으라"는 요청을 정상 입력으로 만들기 때문에 이 결함을 확대시킨다. 그래서 다음 할 일이 좁혀졌다 — 68-6 우선순위 1번(L1)은 이것으로 닫힌다. 남은 것은 같은 프레임에 두 객체가 모두 있고 각 객체가 좌·우에 교차 배치된 데이터(L2)이며, 그것 없이는 ③을 반박할 수 없다. 스크립트 scripts/l1_language_target_selection.py · 결과 docs/v5/detector/l1_target_selection.json · 표본 V6 val 200프레임(seed42 분할)
68-8. 액션까지 바뀌는가 — 반사실 실험에서 기대와 반대가 나왔다
68-7 ②에서 미룬 질문을 실제로 측정했다. 미룬 이유는 "헤드 입력이 6프레임 윈도우라 단일 프레임 교체로는 재구성되지 않는다"였는데, exp73 학습 캐시가 에피소드 단위로 vis를 들고 있고 swap_bboxes()가 vis는 그대로 두고 bbox만 교체하는 용도로 이미 존재했다 → 윈도우를 정상적으로 재구성할 수 있었다. 설계 — 같은 val 33에피소드 · 같은 vis(장면 외형) · 같은 학습된 헤드(배포 arm, 3 seed). bbox만 교체: baseline = OWL "gray basket", 반사실 = OWL "chair"(새로 추출), 미검출은 서빙과 같은 fallback. 주 지표는 사전에 방향 일치율로 고정했다 — sign(Δ좌질량)이 sign(cxbasket − cxchair)와 같은 비율. chair가 더 왼쪽이면 좌질량이 늘어야 하고, 우연이면 50%다. bbox 셔플 대조군도 같이 돌렸다. arm대상 n예측 변화율Δ좌질량 평균|Δ좌질량|방향 일치율 chair (지시문 교체) 152 21.7% −0.0142 0.1042 35.1%±0.6 bbox 셔플 (대조군) 501 27.9% +0.0484 0.1411 — 결정 시점 501 · chair 검출 30.3% · 방향 판정은 |Δcx| > 0.02인 152시점만 사전 고정 기준에서 실패했다 방향 일치율 35.1%는 우연(50%)보다 낮다 — chair를 왼쪽에서 찾았는데 헤드의 좌질량은 오히려 줄었다. 게다가 |Δ좌질량| 0.104가 bbox를 무의미하게 셔플한 대조군 0.141보다 작다. → 즉 그라운딩은 지시문을 따라갔지만(68-7), 그 좌표가 액션으로 올바르게 번역되지 않았다. 이 설계로는 원인을 특정할 수 없다 — 두 설명이 남는다: (A) 헤드가 cx를 거의 쓰지 않는다, (B) 쓰지만 chair의 cx=0.089가 학습 분포 밖이라 무너진다. chair cx가 0.089±0.056에 거의 고정돼 있어 "기대 방향"이 사실상 상수이므로 지표가 "좌질량이 늘었나" 하나로 축퇴한다 — 68-7 ③에서 경고한 한계가 그대로 나타난 것이다. → 68-9에서 검출기를 빼고 cx만 통제해 분리했다. 스크립트 scripts/l1_action_counterfactual.py · 결과 docs/v5/detector/l1_action_counterfactual.json
68-9. 원인 규명 — 배포 헤드는 어떤 cx에서도 좌측을 선호하지 않는다 ⭐
68-8의 (A)/(B)를 분리하려면 검출기를 빼고 cx만 통제 변수로 스윕하면 된다. val 결정 시점의 실제 윈도우를 그대로 쓰고 윈도우 전체 프레임의 cx만 지정값으로 덮어쓴다 (cy·area·has_bbox·vis는 원본 유지, 학습과 같은 bbox_scale=3.0 적용). cx 0.05→0.95를 19단계로 훑으며 좌질량을 본다. 정상이라면 좌질량은 cx에 대해 단조 감소해야 한다. 실제 cx 분위 p1/p50/p99 = 0.188 / 0.500 / 0.818 — 즉 0.05·0.95는 분포 바깥, chair의 0.089도 p1 아래다. cx0.050.150.250.350.450.550.650.750.850.95 배포 (holdaware) −0.088 −0.075 −0.062 −0.050 −0.032 −0.012 −0.004 −0.017 −0.067 −0.145 미러증강 (65-9) +0.141 +0.086 +0.037 −0.016 −0.049 −0.041 −0.006 −0.005 −0.019 −0.029 좌질량 = softmax 좌계열[2,4,6] − 우계열[3,5,7], 3 seed 평균. 양수 = 좌측 선호. ① 배포 헤드 — 좌질량이 전 구간에서 음수다 cx를 화면 맨 왼쪽(0.05)까지 밀어도 좌질량은 −0.088, 즉 여전히 우측을 더 선호한다. 19단계 어디에서도 양수가 되지 않는다. 곡선은 단조가 아니라 역U자로, Spearman이 +0.185(정상이면 −1 근처)이고 극좌·중앙 구간 기울기가 각각 +0.128 / +0.143로 역전이다. → 68-8의 두 설명 중 (A)에 가깝다: 분포 밖만의 문제가 아니라 분포 안(0.3~0.7)에서도 방향이 뒤집혀 있다. cx는 좌측 조향의 근거로 거의 기능하지 못한다. ② 미러 증강이 cx 응답 자체를 복구했다 — 예상하지 못한 결과 같은 데이터·같은 구조인데 미러증강 헤드는 cx 0.05에서 +0.141 (좌측 선호)이고 cx가 커지며 음수로 넘어간다. Spearman −0.575, 극좌 구간 기울기 −0.516(정상). → 65-9에서 미러 증강의 효과를 "고정 편향 제거" (fixed bias −0.0275 → +0.0068)로만 기록했는데, 실제로는 그보다 큰 일을 했다: cx → 조향 방향의 대응 관계 자체를 되살렸다. 65-9는 이 효과를 측정하지 않았으므로, 이건 그 챕터에 대한 사후 보강이다. ③ CH64·CH66과 방향이 맞는다 — 실기 100건에서 최저 구간이 강좌 80% · 약좌 80%(중앙 100%, 약우 95%, 강우 90%)였다. 배포 헤드가 cx로 좌측 조향을 만들어내지 못한다는 것은 좌측 구간이 유독 약한 것과 일관된다. CH66이 원인을 "헤드의 고정 우측 선호"로 지목했는데, 68-9는 그것이 단순한 오프셋이 아니라 입력–출력 대응의 붕괴임을 보여준다. ⚠️ 한계 — 오프라인 프로브다 ⓐ cx만 덮어쓰므로 vis(장면)와 cx가 모순되는 입력이 만들어진다. 실제 주행에서는 둘이 함께 움직이므로, 이 곡선이 실기 거동과 1:1로 대응하지는 않는다. ⓑ 좌질량은 확률 질량이고 argmax가 아니다 — 실제 선택되는 액션의 변화율은 68-8의 21.7%다. ⓒ 미러증강 헤드는 실기 100건 검정을 거치지 않았다. offline 개선이 실기로 이어진다는 보장이 없다는 것은 이 프로젝트에서 여러 번 확인된 사실이다(64-11 철회 사례). → 따라서 결론은 "미러증강 헤드를 실기 100건으로 검정할 근거가 하나 더 생겼다"까지이고, "교체하면 좌측이 개선된다"는 아직 주장할 수 없다. 언어 조건화 계획에 주는 함의 — L1이 그라운딩 수준에서 동작해도(68-7) 액션 수준에서는 지금 헤드로 데모가 성립하지 않는다(68-8). 즉 68-6 우선순위에서 L1 데모의 전제 조건은 L2 데이터가 아니라 헤드의 cx 응답 복구(미러증강 계열)가 먼저다. 스크립트 scripts/l1_head_cx_response.py · 결과 docs/v5/detector/l1_head_cx_response.json