액션헤드 아키텍처 & 손실함수 실험
bbox/vis 특징을 받아 액션을 뽑는 헤드 구조(MLP/LSTM/Transformer/FiLM/cross-attention)와 손실함수(hard CE vs ordinal soft label) 실험 전체.
압축 요약
헤드 구조 자체는 이미 한계에 도달했다. MLP(concat+FC)가 window≥4 조건에서 LSTM·Transformer·cx-Geom·FiLM·Δcx·cx보조손실·actionquery·hybrid·ActionChunk·연속회귀(contreg)·flow(π0 경량판) 등 거의 모든 대안 구조와 견줘도 밀리지 않거나 오히려 더 강건했다(CH34/60/63/70). LSTM은 offline PM은 종종 더 높지만(단일 run 96.85%, 5-seed 평균 95.39%±0.20%p) closed-loop success는 MLP와 통계적으로 구분 안 됨. Transformer는 CH63/70에서 반복적으로 최하위권(closed-loop 18~30%대)이었고, 연속/flow 헤드는 이 데이터 규모(225ep)에서 이산 분류를 못 이겼다(72%대 vs mlp 78%대) — "구조를 바꾸면 좋아진다"는 가설은 여러 축(concat/곱셈적 결합 FiLM/보조손실/cross-attention/청크 앙상블/causal smoothing)에서 반복적으로 기각됐다.
offline val_acc(PM)와 실제 closed-loop 성공률은 자주 괴리된다 — 이것이 이 주제 전체를 관통하는 가장 중요한 방법론적 교훈이다(CH40, CH52, CH63). PM이 크게 올라도(75.9%→89%) closed-loop SR은 그대로거나 떨어질 수 있고(CH40), offline 1위 헤드(cxgeom 78.2%)가 closed-loop에서는 최하위(48.5%)로 뒤집히기도 했다(CH63-8). val 33ep처럼 표본이 작으면 GPU 비결정성·데이터 오염(CACHE_V6 재빌드로 트랙F가 몰래 섞이는 등)만으로도 success%가 25.9%~60.6%까지 요동친다는 게 CH63-11~63-16의 3차 정정 끝에 확정됐다 — 반드시 3-seed 이상 평균/분산으로 보고해야 하며, apples-to-apples(동일 데이터·동일 split 로직) 비교가 아니면 순위 자체가 의미 없다.
다만 CH73의 "그라운딩 서브골 조향" FiLM 변형은 소규모 예비실험에서 긍정적이었다 — 앞 문단의 기각된 FiLM(곱셈적 결합, bbox+image 동등 입력)과 달리, CH73은 bbox를 별도 서브골 인코더로 저차원 임베딩한 뒤 그 임베딩으로 이미지 특징을 FiLM 게이팅(γ,β)하는 구조다. 45ep/794프레임 예비 비교에서 concat-MLP(76.32%±0.99%, 110,536 params) 대비 +1.9%p(78.21%±1.61%, 79,336 params)였고, V6 225ep/10-seed 재검증에서도 steered_reg가 concat 대비 +2.8%p(72.37% vs 69.58%, p=0.0034)로 방향이 유지됐다 — 단, 표본이 여전히 작고 offline PM 기준이라 위 문단의 "PM과 closed-loop의 괴리" 경고가 똑같이 적용된다(실제로 V6 closed-loop replay는 concat 0%/steered_reg 15.6%로 절대값 자체는 낮음). 2026-10-12 팀 미팅에서 액션헤드를 MLP→FM(FiLM)으로 바꾸기로 합의돼(CH74) 이 방향이 EGVLA2 본류로 승격됐다.
손실함수 축이 유일하게 실질적 개선을 낸 축이다(CH70). 조이스틱 연속값(lx,ly,az)을 하드 threshold로 8-class 이산화하면서 생기는 R/FR·F/FR 경계 아티팩트를, hard label 대신 ordinal soft label(sigmoid 완화 + soft CE)로 학습하자 leave-one-direction-out(LOO) 일반화가 평균 +3.71~3.99%p, 최악 방향(strong_right)은 +14.52%p 개선됐다 — 이는 궤적 재생(rollout) 평가에서도 success +9.1%p로 재확인된 유일한 방법이다(CH70-8). 반면 헤드 구조 6종(cxgeom/film/deltacx/cxaux/actionquery)은 무작위 split에서만 좋아 보이다가 LOO에서 개선이 소멸하거나(deltacx: +0.67%p→-0.17%p) R클래스 정확도를 희생하는 트레이드오프만 반복했다.
부수 발견들: (1) 액션 원 신호 중 lx,ly는 실제로 3값({-1.15,0,+1.15})뿐인 이산 신호이고 az만 진짜 연속 신호였다(CH63-9) — 이 진단에 따라 만든 hybrid(6-way+연속az) 헤드는 처음엔 최고로 보였으나 val split 버그 정정 후 mlp보다 낮은 것으로 뒤집혔다. (2) window size는 MLP 기준 w≥4에서 포화, w=4가 FPE 최저(0.094m)인 반면 LSTM은 w=16에서 최저 FPE 0.080m로 긴 히스토리를 더 잘 활용한다(CH35). (3) area_delta(변화율) feature를 추가하면 PG2 그라운더 정밀화로 잃었던 근접 신호가 복원되고 LSTM-replace 조합이 전체 최저 FPE(0.098m)를 달성했다(CH47). (4) STOP override는 오프라인 CL에서 항상 해로웠다(V0 no-override 98.7% vs 서버 기본 override 23.5%, CH37) — 시작 프레임 area 분산이 절대 threshold를 무력화하기 때문. (5) FORWARD 고착의 진짜 원인은 그라운딩 실패가 아니라 액션-그라운딩 라벨 자체의 confound(cx-액션 방향 일치율 VSC 35.5%, 우연 50%보다 낮음)였다(CH62) — 헤드 구조를 아무리 바꿔도 라벨/데이터 커버리지 문제는 해결되지 않는다는 것이 CH70의 결론과도 맞물린다.
아직 미해결: ordinal soft label(D)과 mlp의 조합(mlp+soft)이 다음 배포 후보로 확정됐으나, 실기(real robot) 검증은 아직 수행되지 않았다 — offline/궤적재생 지표가 실주행 성능을 보장하지 않는다는 원칙(확정 발견 6번)이 여전히 유효하다.
챕터별 원문 발췌 (시간순)
FCHead RoboVLMs FCDecoder (deep MLP) 95.3% 93.1% 0.109m exp70 LSTMHead RoboVLMs MobileVLAClassificationDecoder 95.7% 96.6% 0.112m exp54 ActionMLP (ours) — (baseline) 92.6% 96.6% 0.110m 1. LSTM = ActionMLP — 96.6% 동일 RoboVLMs의 LSTM 기반 decoder(MobileVLAClassificationDecoder 구조)가 우리 ActionMLP와 동일한 96.6% CL 달성. Window-baked flat input이 sequential LSTM과 등가임을 실험으로 확인. 우리 MLP는 LSTM보다 파라미터 적고 추론 더 빠르다. 2. FCHead 93.1% — depth는 필요, temporal은 optional Deep MLP(no temporal)로도 93.1% 달성. 단순 linear(69%)보다 훨씬 높다. 작업의 복잡도가 단순 선형 분리를 초과함을 확인. 하지만 temporal context(LSTM/window) 없이는 96.6%까지 오르지 못한다 → bbox window가 중요. 3. Linear 69% — temporal 없으면 한계 명확 1-layer linear는 각 timestep을 독립적으로만 봄. 69% CL — Stage2의 task가 temporal 맥락을 필요로 함을 재확인. RoboVLMs 기여 클레임 정리 ① Kosmos-2 (RoboVLMs) backbone → Stage1 grounding encoder로 활용 ② RoboVLMs E2E (MobileVLAClassificationDecoder) → 0% CL baseline 제공 → decomposition 필요성 증명 ③ lora_B=0 구조적 버그 발견 (forward_continuous에서 gradient 단절) ④ LSTM vs MLP head 비교 (이번) → window-flattened MLP가 RoboVLMs LSTM과 동등·더 경량 → 설계 검증 다음 스텝 ✅ exp68 linear — 69.0% CL ✅ exp69 FCHead — 93.1% CL ✅ exp70 LSTMHead — 96.6% CL (RoboVLMs LSTM과 비교 완료) ⏳ 의자(chair) 데이터 수집 (좌/우 에피소드 추가 필요) 🔲 논문 Table 2-C 확정 후 제출 준비
파이프라인 고정(L2+aug), head별 window 크기 변화 실험
style="border-bottom:1px solid #1e3050"> Head Window val_acc CL (↑) FPE (↓) 비고 MLP 2 94.88% 93.1% 0.145m 방향 파악 불충분 MLP 4 ★ 92.91% 96.6% 0.094m MLP 최소 필요 window. FPE 최저 MLP 8 (baseline) 92.6% 96.6% 0.110m exp54 기본값 MLP 16 89.57% 96.6% 0.102m val_acc 하락, CL 유지 LSTM 4 95.08% 96.6% 0.123m — LSTM 8 (baseline) 95.7% 96.6% 0.112m exp70 기본값 LSTM 16 ★ 96.85% 96.6% 0.080m 전체 최저 FPE. 긴 맥락 LSTM 강점 🔍 핵심 해석 1. MLP: w≥4에서 CL 포화 — w=2는 93.1%로 하락. 최소 4프레임 히스토리 필요. 방향 전환(left/right) 판단에 적어도 4타임스텝의 bbox 이동 패턴이 필요. 2. MLP w=4가 FPE 최저(0.094m) — w=8(0.110m)보다 낮음. 너무 긴 window는 MLP에 noise로 작용. flat concatenation의 한계. 3. LSTM: 모든 window에서 96.6% 유지, w=16에서 FPE 0.080m LSTM은 긴 시퀀스를 선택적으로 활용 가능 → window 길수록 FPE 개선. 4. CL vs val_acc 해리 — MLP w=16: val_acc 89.57%로 가장 낮지만 CL은 동일 96.6%. val_acc는 per-frame 분류 정확도. CL은 trajectory 누적 오차. 두 지표는 별개. 📌 논문 서술용 결론 MLP는 w=4가 최소·최적 (경량 배포 시 권장). LSTM은 w=16에서 최저 FPE 0.080m 달성 — temporal context가 풍부할수록 궤적 정밀도 향상. 두 head 모두 CL 96.6% 동일 → 성공률은 window-insensitive, FPE는 window-sensitive. → Grounding Hub §G — Head Ablation(CH34) + Window Ablation(CH35) 전체 결과 시각화 · 통합 비교표 포함 현재 상태 / 남은 TODO ✅ 파이프라인 원인 확정 (exp65~67) — CH33 ✅ RoboVLMs head ablation (exp68~70) — CH34, LSTM=MLP 확인 ✅ Window size ablation — CH35, MLP w≥4 포화·LSTM w=16 최저 FPE ✅ Grounding Hub §G 연동 — CH34/35 전체 결과 통합 시각화 ✅ 의자 grounding 파이프라인 구축 (100% hit, 스크립트 완료) ⏳ 의자 좌/우 에피소드 수집 (현재 0ep/1ep → 목표 15+15ep) 🔲 의자 Stage2 학습 + CL eval (수집 완료 후 즉시 실행 가능) 🔲 논문 최종 작성 (Table 1/2A/2B/2C/2D 확정 완료, 본문 서술 필요) (function() { const SECTIONS = ['ch1','ch2','ch3','ch4','ch5','cl-overview','cl-dive', 'ch6','ch7','ch8','ch9','ch10','ch11','ch12','ch13','ch14','ch15','ch16','ch17','ch18','ch19','ch20','ch21','ch22','ch23','ch24','ch25','ch26','ch27','ch28','ch29','ch30','ch31','ch32','ch33','ch34','ch35','ch36','ch37','ch38','ch39','ch40','ch41','ch42','ch43','todo-ch44','ch44','ch45','ch46','ch47','ch48','ch49','ch50','ch51','ch52','ch53','ch54','meeting-0626','next-step','summary','weekly-meeting']; const items = document.querySelectorAll('.toc-item[data-target]'); function getActive() { const mid = window.scrollY + window.innerHeight * 0.35; let active = SECTIONS[0]; for (const id of SECTIONS) { const el = document.getElementById(id); if (el && el.getBoundingClientRect().top + window.scrollY { item.classList.toggle('active', item.dataset.target === active); }); } window.addEventListener('scroll', update, {passive: true}); update(); / 클릭 시 패널 자동 닫기 (선택) / items.forEach(item => { item.addEventListener('click', () => { document.getElementById('toc-panel').classList.remove('open'); }); }); })();
3-Layer 체계적 분석 — override 없는 게 최선, 시작 위치 정규화 설계
📌 현재 상태 — 여기서 권고한 "override 없음(proximity 규칙 기반)"은 현재 미사용입니다. 현 배포는 stop_mode=learned(헤드의 STOP 클래스) + 콜드스타트 가드 3프레임을 씁니다. 과거 proximity 규칙(area≥0.25 & |cx−0.5|≤0.35, N=3)은 폐기됐습니다.
왜 STOP을 분석하는가
실제 추론 서버(stage2_v2_inference_server.py)에는 Proximity Override가 활성화되어 있다 (area≥0.25 AND |cx-0.5|≤0.35, 2프레임 연속). 그러나 96.6% CL은 이 override 없이 달성된 수치다(eval_exp54_stage2_v2_closedloop.py에 override 없음). 실제 로봇과 시뮬레이션 메트릭 사이에 괴리가 있다는 의미 — 어떤 STOP 전략이 진짜로 나은가를 체계적으로 검증한다.
모델별 테스트 범위
모델
역할
STOP ablation
이유
Stage2 v2 (Exp66)
현재 action model
✅ 완료
Kosmos-2 vision enc + ActionMLP. CL 96.6% 달성 모델.
E2E Kosmos-2 (Exp11)
구 action model
❌ 불필요
CL 0% — 방향 오류 누적. STOP 자체가 의미 없음. 체크포인트 billy 전용.
PaliGemma2
bbox grounding 소스
⚠️ 소스 비교
action model 아님. HSV vs PG2 bbox area 분포 차이 → threshold 거동 다름 (L4에서 비교).
3-Layer Ablation 설계
L1 — Parameter Sweep
재학습 없음 · 6 variants
area/cx/cy threshold 조합 탐색. V0(no override)~V5(strict area only). 결과: V0 98.7% 압도적 최선.
참고: IndoorUAV (2025) 룰 기반 STOP 설계
L2 — CLIP Cosine-Sim STOP
재학습 없음 · 5 thresholds
학습셋 area>0.25 프레임 CLIP feature 평균 → ref 벡터. cosim > th AND consec=2 → STOP. th=0.70~0.90 전부 SR 0% — 초기 프레임부터 ref와 cosim 과다.
참고: NaVILA (2025) 시각 임베딩 goal 감지, CompassNav (2025) VLM Stop Agent
L3 — STOP-Weighted Training
재학습 · 4 weight variants
STOP 프레임 0개 → 마지막 프레임 합성 주입(118개). stop_weight_mult ×1/2/5/10. val_acc 0.926→0.80 하락 (STOP 강제 학습의 부작용). CL eval 미포함(별도 실행 예정).
참고: LongNav-R1 (2025) stop token + RLVR 학습
L1 결과 — STOP Parameter Sweep (5 seeds)
Variant
알고리즘
SR
FPE
해석
V0 no_override ★
모델 argmax 그대로
98.7%±1.6%
0.071m
STOP 학습 없어도 궤적 자체가 전문가와 유사 → TLD·FPE 모두 만족
V1 current_server
area≥0.25 & |cx-0.5|≤0.35 & c=2
23.5%±3.2%
1.233m
에피소드 33.7% 지점에서 발동(93% 에피소드) → TLD < 0.7 폭락
V2 cx_removed
area≥0.25 & c=2
23.5%±3.2%
1.233m
cx 조건 제거해도 동일. area 조건만으로 이미 93% 발동 중
V3 cx_rm+cy≥0.45
area≥0.25 & cy≥0.45 & c=2
96.0%±2.5%
0.116m
cy가 발동 시점을 지연. 실제 로봇 후보로 2위
V4 area_adaptive
area≥0.40 즉시 / else V1
23.5%±3.2%
1.233m
하위 threshold(0.25)가 상위(0.40)보다 먼저 발동
V5 area_only_035
area≥0.35 & c=2
24.2%±4.0%
1.227m
threshold 올려도 area 분포 자체가 초반부터 고값
V0(no_override) vs V1(서버 기본값) 궤적 비교 — 위 표의 98.7% vs 23.5% 차이가 실제로 어떻게 생긴 경로 차이인지, val 에피소드 3개를 다시 돌려 그려봤다(새 학습 없음, 기존 ckpt 재사용):
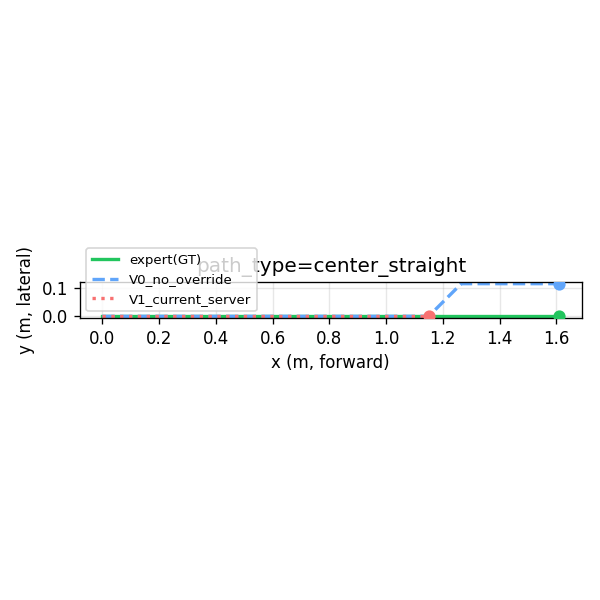 center_straight — V1이 1.15m 지점에서 일찍 멈춤(빨간점), expert/V0는 1.6m까지 계속
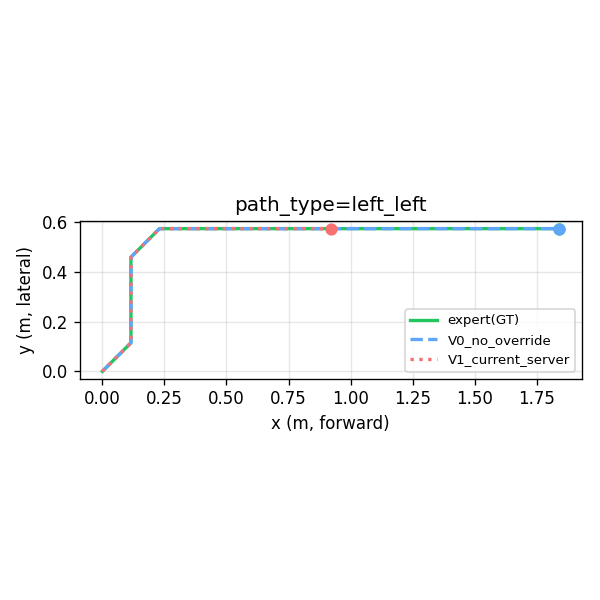 left_left — 이 에피소드는 V0/V1 거의 동일(둘 다 성공 케이스)
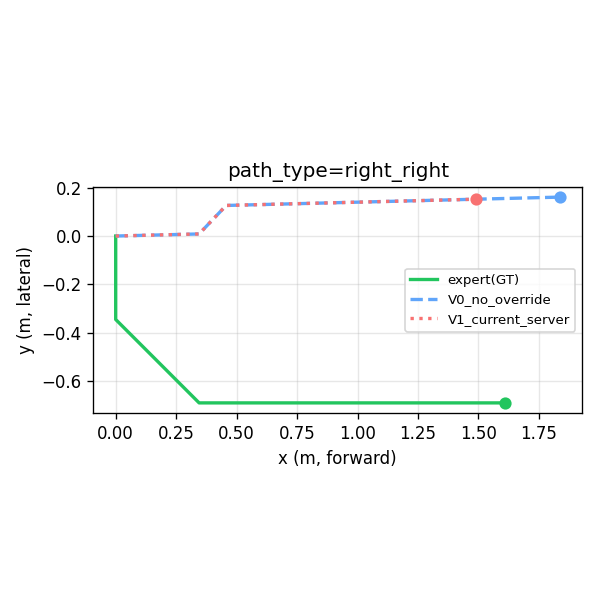 right_right — V0/V1은 일치하지만 둘 다 expert와 반대 방향(별개의 모델 예측 오류, STOP override와 무관)
핵심 진단: 시작 프레임 area 분산이 threshold를 무력화
area[frame=0]: min=0.027 / max=0.636 / mean=0.258 / std=0.271 val 에피소드의 40%가 시작 프레임부터 area ≥ 0.25 → V1이 frame 0에서 즉시 발동. 결론: 절대값 threshold는 출발 위치에 따라 완전히 다르게 거동한다. 로봇이 바스켓 가까이서 시작하면 어떤 area 기준도 의미가 없다. → 시작 프레임 기준 정규화(delta/relative area) 또는 warm-up guard가 필요. L4 — 정규화 Variants (시작 위치 보정) V6 — min_steps guard 처음 5프레임 동안 STOP 금지. warm-up 이후에만 area 조건 검사. min_steps=5, area≥0.25, cx_tol=0.35 V7 — delta area area_t − area_0 ≥ 0.15. 절대값이 아닌 성장량 기준. 시작 위치 무관. delta_th=0.15, consec=2 V8 — relative area area_t / area_0 ≥ 2.5. 시작 대비 2.5배 성장. 스케일 정규화. rel_th=2.5, consec=2 V9 — guard + delta V6 + V7 조합. 초반 3프레임 제외 + 성장량 조건. min_steps=3, delta_th=0.15 Variant HSV SR (5 seeds) PG2 SR (부분) 해석 V0 no_override ★ 98.8% ~80.5% PG2 bbox로 HSV-trained MLP 구동 시 distribution shift → 성능 하락 V6 min_steps_5 ~중간 — warm-up만으로는 area 분포 문제 미해결 V7 delta_area ≥0.15 ~58% ~62% 성장량 기준이 절대값보다 낫지만 V0 대비 여전히 열세. STOP 자체가 궤적 품질 저해 V8 rel_area ≥2.5× ~52% ~3% PG2 area 분포가 HSV와 달라 2.5× 기준이 즉시 발동 → 거의 즉시 STOP
L4 추가 발견: PG2 grounding으로 구동 시 V0도 ~80%로 하락
Stage2 MLP는 HSV bbox(cx/cy/area)로 학습됨. PG2 detector의 area_det 분포가 다름 → feature distribution shift → action 예측 저하. grounding 소스가 학습/평가에서 동일해야 한다는 것이 재확인됨. V8(rel_area)은 PG2에서 ~3%로 폭락 — PG2의 초기 area_det가 HSV보다 크거나 배율 기준 자체가 소스에 민감함. ⏳ PG2 seed 3~5 실행 중. 완료 후 최종 수치 업데이트 예정. L3 결과 — STOP-Weighted Training Variant stop_weight_mult val_acc CL eval sw1x (baseline) ×1.0 0.7972 예정 sw2x ×2.0 0.8091 예정 sw5x ×5.0 0.7992 예정 sw10x ×10.0 0.7913 예정
L3 해석: 합성 STOP 주입이 전체 정확도를 희생
원래 val_acc 0.9259 → 합성 STOP 118개 추가 후 0.797~0.809로 하락. STOP 학습을 강제하면 FORWARD/LEFT/RIGHT 등 기존 action 분류가 저하됨. weight_mult ×1~×10 구간 모두 비슷 → STOP 합성 프레임 수(118개)가 부족한 것이 아니라 합성 방식(마지막 프레임 복제)의 한계. CL eval 결과는 별도 실행 후 업데이트.
CH37 결론: 오프라인 CL에서 STOP override는 항상 해롭다 — 실제 로봇 테스트가 필요
- V0 no_override = 98.7% — STOP 없이도 전문가 궤적 모방으로 충분.
- V1(현재 서버 기본값)은 에피소드의 33.7% 지점에서 강제 정지 → TLD < 0.7 → 23.5%로 폭락.
- CLIP cosim STOP은 초기 프레임부터 발동 → 0%.
- 시작 위치 정규화(delta/relative area, L4)가 구조적 해결책 — 결과 대기 중.
- V3(cy≥0.45)이 현재로선 실제 로봇용 차선 후보 (SR 96.0%, FPE 0.116m). ※ 오프라인 CL의 성공 기준(FPE·TLD)은 STOP 타이밍에 매우 민감. 실제 로봇 테스트로만 진짜 STOP 전략을 검증 가능. scripts: ablate_stop_proximity.py · ablate_stop_clip_sim.py · ablate_stop_weighted_train.py · ablate_stop_normalized.py | 2026-06-18
T1(임의 객체 신뢰성) 확정 + T2(언어가 경로에 영향) 사전검증, 새 데이터 수집 없이 기존 V5 220개 에피소드 재사용
CH38의 "VLA-ness" 등급(T0~T3)을 다시 가져와, 이번엔 T0(이미 구현됨) → T1 확정과 T2 사전검증까지 진행했다. T3(완전 통합 재학습)은 여전히 다루지 않음 — 다음 plan으로 분리.
39-1. Step A — 바스켓 전용 그라운딩 필터 버그 수정 (T1 확정)
soda 실측 중 사과(apple) grounding이 종종 실패하는 걸 발견 — 원인은 PG2가 아니라
PG2Grounder.run()에 박혀있던 4개 후처리 필터 중 cy_val<0.35("바구니는 화면 상단에 없다"는
가정)였다. 사과의 정상 bbox는 cy=0.344로 이 임계값에 걸려 false negative 처리됐다.
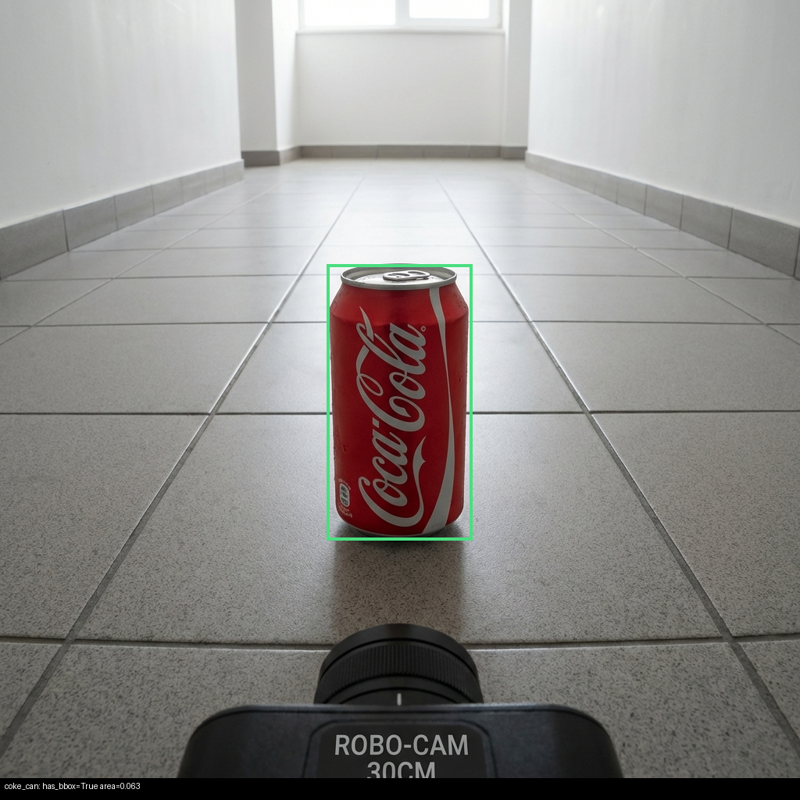 콜라캔 — area=0.063, 정상
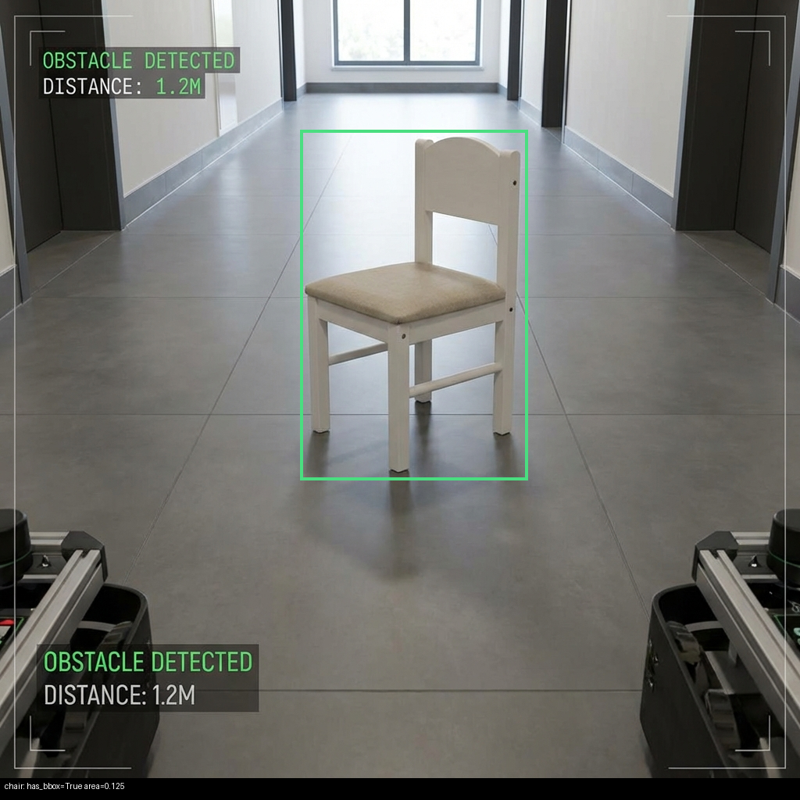 의자 — area=0.125, 정상
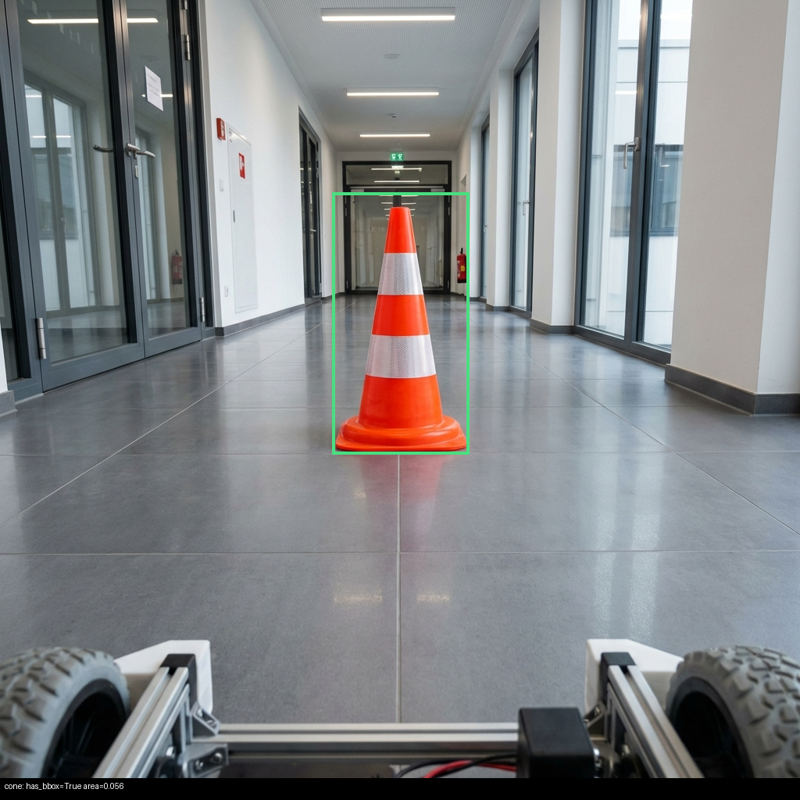 콘 — area=0.056, 정상
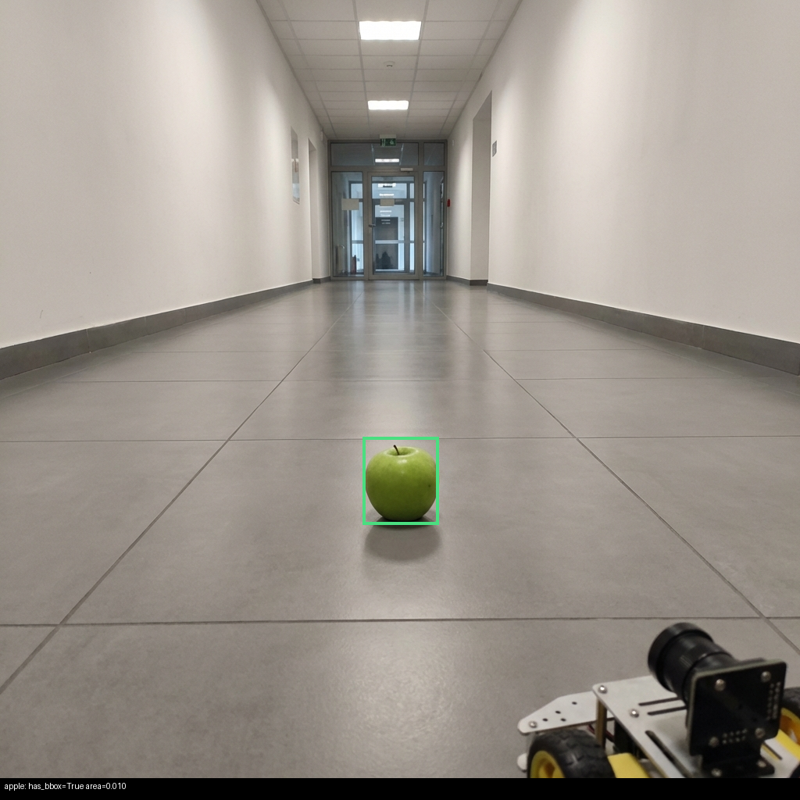 사과 — GB10에선 area=0.010 정상검출(필터 버그 수정 효과). soda(Jetson)에서만 5/5 풀프레임 환각
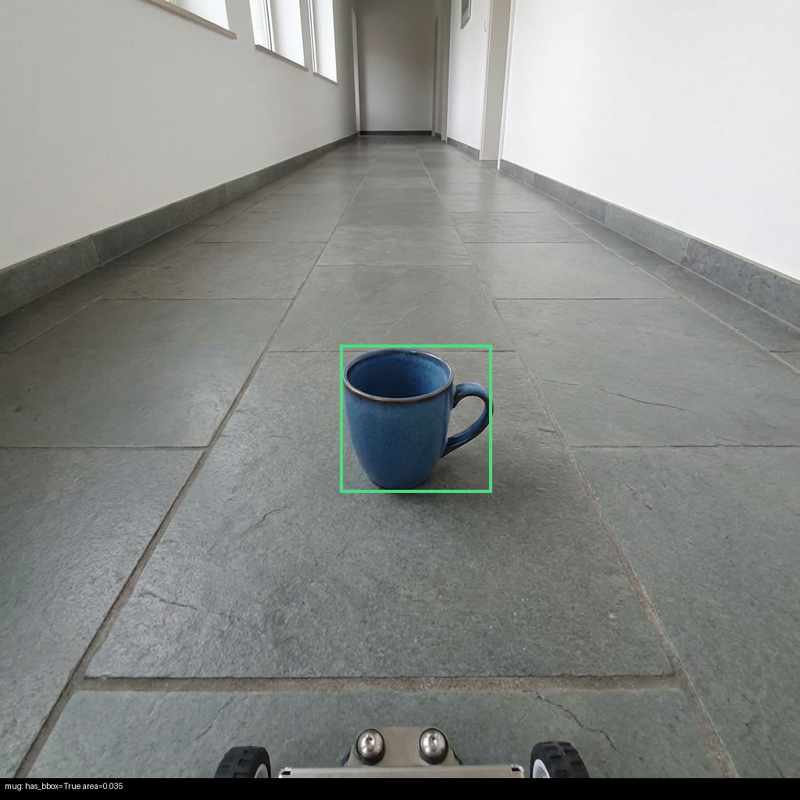 머그컵 — GB10에선 area=0.035 정상검출. soda에서만 5/5 풀프레임 환각
객체soda 검증(수정 후)비고
콜라캔 / 의자 / 콘
✅ has_bbox=True, 안정적
3/5 정상
사과 / 머그컵
❌ False — 필터 버그는 아님
soda(Jetson)에서 5회 반복 모두 동일한 full-frame 환각 — GB10에서는 정상 박스가 나왔던 것과 대비, bf16 연산의 하드웨어 의존적 불안정성으로 추정(별도 이슈)
area>0.9(전체화면 환각 차단)·x-full-width 필터는 객체 무관 보편 규칙으로 유지,
min_cy/min_area만 phrase별로 오버라이드 가능하게 분리(configs/ground_filter_map.json) —
미등록 phrase는 기존 바스켓 기준 그대로 하위호환.
39-2. Step B — 기존 V5 데이터로 "방향 신호가 hidden state에 있는가" 저비용 검증
CH38-5는 "PG2에 방향을 텍스트로 직접 명령했을 때 생성 출력이 안 바뀐다"를 보였다.
이번엔 다른 질문: 텍스트는 고정("detect gray basket")인데 이미지(실제 주행 장면)만 다를 때
hidden state가 경로방향과 상관되게 갈리는가 — 새 데이터 수집 없이 V5 220개 에피소드
(파일명에 이미 target_{시작위치}_{방향}_path 라벨 존재)의 중간 프레임으로 frozen 선형 probe(Exp54와 동일 방법론) 측정.
probe가 90%로 구분한 게 실제로 어떻게 다르게 생긴 화면인지 — 9개 (시작위치×방향) 조합의 실제 예시 프레임:
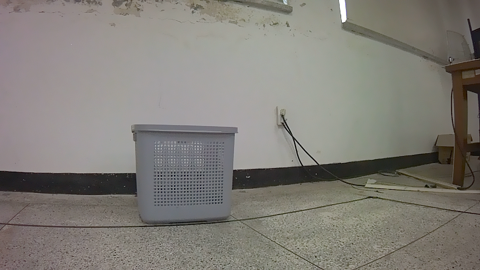 중앙 출발 · 좌회전 경로
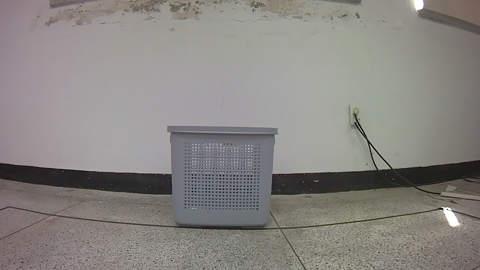 중앙 출발 · 직진 경로
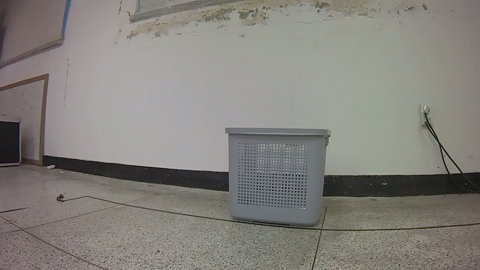 중앙 출발 · 우회전 경로
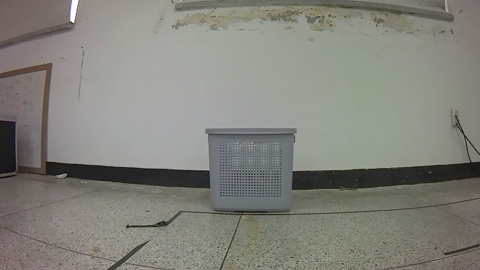 좌측 출발 · 좌회전 경로
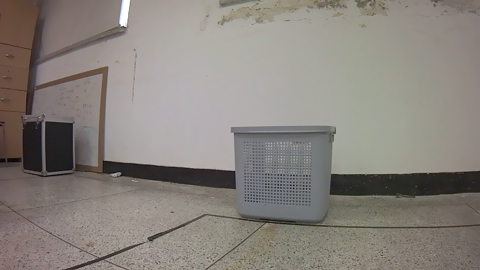 좌측 출발 · 직진 경로
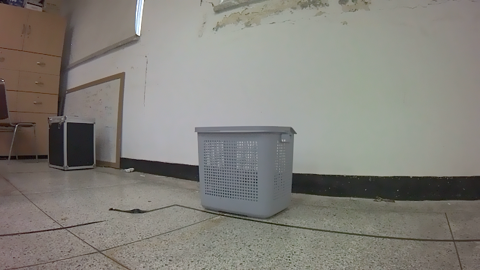 좌측 출발 · 우회전 경로
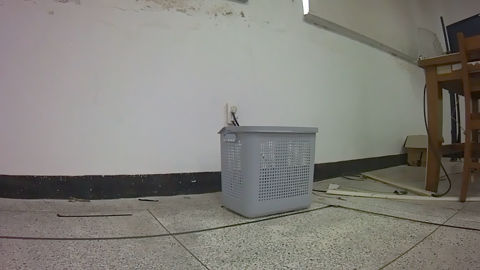 우측 출발 · 좌회전 경로
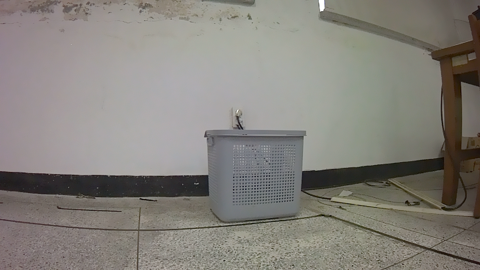 우측 출발 · 직진 경로
 우측 출발 · 우회전 경로
proben_classchance5-fold CV accchance 대비
방향(좌/직진/우)
3
0.333
0.900 ± 0.031
2.70x
출발위치(중앙/좌/우)
3
0.333
0.991 ± 0.018
2.97x
출발위치×방향(결합)
9
0.111
0.923 ± 0.027
8.30x
결론: 방향만 봐도 90.0%(chance 33.3%) — PG2의 내부 표현(hidden state)에는
지금 action head가 쓰는 bbox 좌표/면적보다 훨씬 풍부한 장면 정보가 이미 들어있다.
CH38-5와 모순되지 않는다 — "텍스트로 직접 지시"는 안 통했지만, "이미지에 실제로 담긴 방향 관련 시각 정보"는
hidden state에 강하게 인코딩되어 있다는, 별개로 긍정적인 발견.
다음 단계(이번 plan 범위 밖, 별도 승인 필요): action head 입력을 bbox 좌표 대신(또는 추가로)
PG2 hidden state로 바꾸고, 기존 V5 220개 에피소드 라벨로 head만 재학습 —
새 데이터 수집 없이 T2(언어/장면이 경로에 영향)로 가는 가장 저비용 경로.
plans: plan_20260622_fundamental_vla.md | 2026-06-22
CH39 Step B(probe 90%)의 다음 단계: bbox 좌표 대신/추가로 hidden state를 넣어 head만 재학습 — 새 데이터 수집 없음. 단, 최초 PM 비교에 측정 오류가 있었음(40-1b에서 정정)
CH39에서 "PG2 hidden state에 방향 신호가 있다"는 걸 frozen probe로만 확인했다. 이번엔 실제로 action head 입력에 hidden state를 추가/대체해서 head만 재학습(VLM 전부 frozen, 새 데이터 수집 없음, 기존 150개 에피소드의 동일 train/val split 재사용)하고, PM과 closed-loop 양쪽으로 baseline(Exp54 Step2)과 비교했다.
40-1. PM(프레임 정확도) — 두 변형 모두 baseline 대비 크게 상승 (⚠ 아래 40-1b에서 정정됨 — baseline 75.9%는 실측값이 아니었음)
add: 기존 288차원(bbox 32 + image 256)에 hidden state 2304차원을 추가(2592차원). replace: bbox 32차원을 제거하고 image 256 + hidden 2304(2560차원)로 대체. hidden state는 미리 추출해 캐시한 값(scripts/eval/extract_v5_hidden_states_full.py, 147/150 에피소드·2572프레임, GB10에서 9.6분)을 그대로 로드만 — 학습 중 PG2 재추론 없음. 변형입력 차원val PMbaseline 대비 baseline(bbox+image) 288 75.9% — add(bbox+image+hidden) 2592 89.2% +13.3%p replace(image+hidden) 2560 87.8% +11.9%p bbox 좌표를 완전히 빼도(replace) baseline보다 훨씬 높다 — hidden state 혼자서도 bbox+image 조합보다 나은 표현력. 다만 bbox를 같이 쓰는 add가 근소하게 더 높아, 두 정보가 완전히 중복되진 않는다.
40-1b. 정정 — baseline "75.9%"는 같은 파이프라인으로 측정한 값이 아니었다
train_hidden_state_action.py 출력에 박혀있던 "참고: Exp54 Step2(bbox+image) baseline PM=0.759"는 CLAUDE.md에 적힌 과거 공식 수치(다른 평가 스크립트·다른 메트릭 기준)를 그대로 인용한 하드코딩된 문자열이었다 — 이번 학습과 같은 코드·같은 seed=42 split·같은 평가 함수로 baseline을 실제로 측정한 적이 없었다. hub 통합 작업 중 V5 실제 에피소드를 순차로 테스트하다가 이상한 점을 발견해서(사용자 질문으로 촉발) 역추적했다. 두 가지를 다시 측정했다(둘 다 같은 val 29~30개 에피소드, 같은 seed=42 split): - scripts/eval/grounding_quality_vs_error.py — 기존 운영 ckpt(stage2_v2_mlp.pt, 자체 로그 val_acc=0.935)를 이 split에 그대로 평가 → 92.3% - train_hidden_state_action.py --use_hidden_state none — add/replace와 100% 동일한 코드로 baseline을 처음부터 새로 학습 → 89.76% 변형val PM (정정)baseline(none) 대비 baseline (none, 동일 파이프라인 재학습) 89.76% — add(bbox+image+hidden) 89.17% -0.6%p replace(image+hidden) 87.80% -2.0%p 참고: 기존 운영 ckpt(다른 학습 run) 92.3% 학습 variance 범위 정정된 결론: 진짜 apples-to-apples로 보면 hidden state를 추가해도 PM이 안 오른다 — 오히려 소폭 떨어진다. 40-1의 "+13.3%p" 서사는 잘못된 비교 기준 때문에 생긴 착시였다. CH39 Step B(frozen probe 90%)가 보여준 "hidden state에 방향 신호가 있다"는 사실 자체는 여전히 유효하지만, 그 신호를 action head가 bbox+image보다 더 잘 활용한다는 증거는 이번 실험에서 안 나왔다 — 가능한 이유: (1) 단일 seed 학습이라 노이즈가 차이(1~2%p)를 압도, (2) 2304차원 hidden state가 작은 MLP에는 너무 고차원이라 오히려 과적합/최적화가 어려움, (3) bbox+image 조합이 이미 충분히 정보를 담고 있어 hidden state가 redundant.
40-2. Closed-loop SR — PM 상승이 그대로 옮겨지지 않음 (이 절의 SR 수치 자체는 정정 영향 없음 — baseline에 기존 운영 ckpt를 그대로 썼기 때문)
CH37 결론(STOP override 없는 게 최선)에 맞춰 override 없이 모델 argmax 그대로 trajectory를 만들어 비교했다(scripts/eval/closed_loop_eval_hidden_state.py, val 29개 에피소드, 동일 seed=42 split). 변형SRFPETLD baseline(bbox+image) 96.6% 0.110m 1.008 add(bbox+image+hidden) 93.1% 0.172m 1.017 replace(image+hidden) 96.6% 0.171m 1.025 솔직한 결과: PM이 75.9%→89%로 크게 올랐는데 closed-loop SR은 그대로(replace)이거나 오히려 살짝 낮다(add, -3.5%p). 원인 추정: 이 eval 방식(override 없음)에서는 baseline부터 이미 96.6%로 천장에 가깝다(val 29개 에피소드라 표본도 작음) — 늘어난 프레임 정확도가 FORWARD-dominant 구간의 미세한 차이라서 에피소드 단위 성공/실패(이진 판정)에는 거의 영향을 못 준 것으로 보인다. 과장하지 않고 그대로 적는다: "PM은 확실히 좋아졌지만, 이 작은 val set·이 success 기준에서는 SR로 이어지지 않았다."
40-3. 종합(정정) — "표현 레벨"엔 신호가 있는데, "head 재학습"으로는 아직 못 꺼냈다
40-1b 정정 이후 다시 보면: CH39 Step B(frozen probe, 90%)는 여전히 유효하다 — PG2 hidden state에는 방향과 상관된 신호가 분명히 있다. 하지만 CH40이 시도한 방식(2304차원 원시 hidden state를 그대로 작은 MLP에 concat/대체)으로는 그 신호를 bbox+image보다 더 잘 활용하지 못했다 — PM이 같거나 오히려 살짝 낮다(-0.6~-2.0%p, 단일 seed 학습 노이즈 범위일 가능성도 있음). "probe에서 보인다"와 "이 방식으로 재학습하면 더 잘 쓴다"는 서로 다른 주장이고, 이번 실험은 후자를 지지하지 않는다. 다음 단계(범위 밖): (1) hidden state를 원시 2304차원 그대로 넣지 말고 차원축소(PCA/학습 가능한 linear projection)해서 다시 시도 — plan_20260622_hidden_state_action_head.md §1의 "C안"으로 미뤘던 경로, (2) 단일 seed가 아니라 5-seed 평균으로 노이즈와 실제 효과를 구분, (3) 이번 세션에 새로 나온 그라운딩 품질 진단(CH41 예정)에 따라 — head 구조보다 그라운딩/인식 품질 자체를 개선하는 쪽이 더 근본적인 우선순위일 가능성(has_bbox=False 프레임의 오류율이 has_bbox=True보다 3~5배 높음). plans: plan_20260622_hidden_state_action_head.md | 2026-06-22
17개 조합(MLP계열 14 + LSTM 3) 비교 — LSTM+hidden state(add)가 최고(단일 run 96.85%, 5-seed 평균 95.39%±0.20%p), hidden state보다 head 구조가 더 강한 factor
⚠️ 이 결론은 이후 뒤집혔습니다 — "head 구조가 가장 강한 factor"는 시뮬레이션 기준이었습니다. CH63에서 mlp≈transformer로 헤드 간 차이가 사라졌고, 64-18에서 병목은 헤드가 아니라 그라운딩임이 실기로 확정됐습니다(gnd%≥80 → 98.8%). 액션 헤드는 0.866M으로 이미 충분합니다. CH40/41은 원시 2304차원 hidden state를 그대로 concat/대체해서 baseline(window=8, 91.54%)을 못 넘었다. 이번엔 hidden state 앞에 학습 가능한 linear projection(2304→proj_dim)을 둬서 "어떤 정보를 얼마나 쓸지"를 역전파로 배우게 했다 — 명시적 가중치 스칼라보다 표현력이 높고 구현은 단순하다. 거기에 head 구조(linear/mlp/fc)까지 같이 바꿔가며 14개 조합을 비교했다.
43-1. Projection 차원 ablation — 작을수록 좋다, 32에서 baseline을 처음으로 넘었다
scripts/train_hidden_state_projected.py --proj_dim {32,64,128,256}, head=mlp(기본) 고정, window=8. proj_dimaddreplace 32 94.29% 93.31% 64 91.34% 91.34% 128 90.35% 90.35% 256 89.76% 88.58% 결론: proj_dim이 작을수록 일관되게 좋다(32 > 64 > 128 > 256) — CH40/41의 가설(2304차원이 너무 고차원이라 작은 MLP가 못 배운다)이 맞았다. proj_dim=32에서 처음으로 baseline(91.54%)을 넘었다(add 94.29%, +2.75%p / replace 93.31%, +1.77%p).
43-2. Head 구조 ablation(proj_dim=32 고정) — FC head+replace가 MLP계열 중 최고 (43-2b에서 LSTM이 이걸 다시 넘음)
--head_type {linear,mlp,fc}, proj_dim=32 고정(43-1 최선값). headaddreplace linear(1-layer) 91.34% 90.55% mlp(기존, 43-1과 동일 설정 재실행) 93.70% 92.72% fc(deep MLP, RoboVLMs 스타일) 93.90% 94.09% 참고: mlp/add/proj32는 43-1에서 94.29%였는데 같은 설정을 43-2에서 다시 돌리니 93.70%로 0.6%p 차이가 났다 — 학습 셔플 순서가 고정 시드가 아니라서 생기는 런 간 노이즈 폭(±0.5~1%p)으로 해석해야 한다. 그래도 14개 조합 중 다수가 baseline(91.54%)을 일관되게 넘는다는 큰 그림은 노이즈로 설명되지 않는다.
43-2b. RoboVLMs LSTM head 추가(사용자 요청) — 전체 최고, hidden state 없이도 압도
scripts/train_hidden_state_lstm.py — 원래 운영 서버의 LSTMHead(RoboVLMs 스타일)를 윈도우 8프레임 시퀀스로 그대로 가져와서, 매 윈도우 스텝마다 그 프레임의 hidden state(proj_dim=32)를 같이 넣는 구조로 확장. mode=none은 hidden state 없이 LSTM만(원래 구조 그대로) 재현한 것. LSTM 변형val PM앞선 최고(MLP+fc, 94.09%) 대비 LSTM, hidden state 없음(none) 95.87% +1.78%p LSTM + hidden state(add) 96.85% ← 전체 최고 +2.76%p LSTM + hidden state(replace) 95.47% +1.38%p 중요한 재해석: hidden state가 전혀 없는 LSTM-none(95.87%)만으로도 이미 지금까지 나온 모든 MLP 계열 결과(hidden state를 넣은 것 포함, 최고 94.09%)를 넘는다 — "시퀀스를 제대로 모델링하는 head 구조(LSTM)"가 차원축소나 hidden state 추가보다 더 강한 단일 factor였다. 다만 LSTM+hidden(add)이 96.85%로 LSTM-none보다도 +0.98%p 더 높아, hidden state가 LSTM 구조 위에서는 추가적인 보탬이 된다는 것도 확인됐다 — 43-1/43-2의 "MLP에선 hidden state가 큰 효과"라는 결론은 "LSTM이면 hidden state 없이도 이미 강하고, 있으면 더 좋다"로 업데이트해야 한다.
43-2c. PM 96.85%가 실주행(closed-loop)으로 이어지는가? — SR은 동일, FPE는 개선
CH40에서 본 "PM은 오르는데 SR은 안 따라온다"는 패턴이 LSTM에서도 재현되는지 직접 확인했다(사용자 요청, scripts/eval/closed_loop_eval_lstm.py, override 없이 argmax 그대로, val 29개 에피소드). LSTM 변형SRFPETLDPM(참고) none 96.6% 0.101m 0.994 95.87% add 96.6% 0.086m ← 최저 0.993 96.85% replace 96.6% 0.099m 1.003 95.47% 솔직한 결과: SR(성공/실패 이진 판정)은 세 변형 다 96.6%로 동일 — CH40의 "PM↑인데 SR은 안 따라온다"는 패턴이 LSTM에서도 재현됐다(val 29개·success 임계값 0.5m 안에서 전부 이미 성공이라 이진 판정으로는 차이가 안 보임, 천장효과). 다만 연속값 지표인 FPE는 add가 확실히 가장 낮다(0.086m, none 대비 약 15% 개선) — PM 96.85%가 의미 없는 숫자는 아니고, 성공 판정 임계값 안에서의 경로 정밀도 개선으로 실제 나타난다는 게 정확한 해석이다.
43-2d. 추가 검증 — proj_dim 8/16 확장 + 5-seed 노이즈 점검 (96.85%는 노이즈 상단이었다)
"자동으로 진행해도 돼" 지시에 따라 두 가지를 추가로 돌렸다: ① proj_dim을 32 아래(8, 16)까지 더 줄여서 한계 확인, ② LSTM+add+proj32(원래 96.85%)를 시드만 바꿔 5회 반복해서 그 숫자가 노이즈인지 확인. 조합val PM MLP, proj=8, add / replace 94.29% / 94.49% MLP, proj=16, add / replace 93.90% / 93.90% LSTM, proj=8, add 96.85% LSTM, proj=16, add 96.46% LSTM+add+proj32 — 5회 반복(시드만 다름)val PM run 1~5 95.08% / 95.28% / 95.67% / 95.47% / 95.47% 평균 ± 표준편차 95.39% ± 0.20%p 원래 보고했던 단일 run 96.85% (5-seed 평균보다 +1.46%p 높음 — 노이즈 상단값) 정직한 재해석: 43-2b에서 "전체 최고 96.85%"라고 적었던 건 5번 중 가장 잘 나온 한 번의 결과였다 — 5-seed 평균은 95.39%±0.20%p로 더 낮다. 그래도 baseline(window=8 MLP, 91.54%)보다는 여전히 확실히 높고(+3.85%p), proj_dim 8/16/32가 LSTM에서는 서로 비슷한 수준(96.46~96.85%, 단일 run 기준)이라 "32가 정확히 최적"이라는 43-1의 결론도 8~32 구간에서는 노이즈 수준 차이로 봐야 한다. 핵심 결론(head 구조가 가장 강한 factor)은 그대로 유지되지만, 정확한 숫자를 인용할 땐 5-seed 평균(95.39%)을 써야 한다.
43-3. 종합(업데이트) — factor 순위 재정리: head 구조(LSTM) > 차원 > 그라운딩 > hidden state 유무
43-2b 이후 factor 순위를 다시 정리하면: ① head 구조(LSTM vs MLP) — 가장 강력, hidden state 없이도 baseline을 +4.3%p 상회(91.54%→95.87%) ② hidden state 차원(32가 최선, CH43-1) ③ 그라운딩 품질(CH41, has_bbox 유무로 오류율 3~5배) ④ hidden state 자체(LSTM 위에서는 보탬이 되지만 단독으론 head 구조 효과보다 작음, +0.98%p) ⑤ 텍스트 명령(CH42, 거의 무영향). 처음 가설(hidden state가 핵심)과 달리, 실제로 가장 큰 차이를 만든 건 시퀀스 정보를 쓰는 head 구조였다 — MLP는 윈도우 8프레임의 bbox 히스토리만 flat하게 펴서 넣고 시간 순서 정보를 버리는데, LSTM은 그 순서를 그대로 활용한다. 다음 단계(범위 밖): LSTM+hidden(add)+proj32(96.85%)를 closed-loop으로 평가해서 CH40에서 본 "PM은 올라도 SR은 안 오른다" 문제가 이 조합에서도 재현되는지 확인, 그리고 CH41의 그라운딩 품질 개선과 병행. 🧠 Hidden State Hub — CH39~43 한 페이지 요약 | plans: plan_20260622_hidden_state_projection_weighting.md | 2026-06-22
CH46-5 가설 검증 — 회전 직전 area 분산 소실로 FPE 악화됐던 문제를 윈도우 내 변화율 feature로 복원 시도
47-1. 결과 — SR/FPE 모두 복원됨
윈도우 8프레임 × [cx,cy,area,has_bbox]에 area_delta = area[t]-area[t-1]를 5번째 채널로 추가 (32→40차원). --use_hidden_state none만 1차 검증(MLP+LSTM). 구성SRFPE 기존(5월 Kosmos-2, CH43) 96.6% 0.101m PG2만(CH46, area_delta 없음) 93.1% 0.145m PG2 + area_delta(이번) 96.6% 0.121m val_acc(PM)도 함께 개선: MLP-none 93.90%→94.29%(+0.39%p), LSTM-none 94.88%→95.08%(+0.20%p). 결론: CH46-5의 가설이 맞았다. SR이 기존(Kosmos-2 시절) 수준으로 완전히 복원됐고, FPE도 PG2 단독(0.145m) 대비 개선(0.121m) — none 모드 단독으로는 기존(0.101m)에 아직 못 미치지만, add/replace까지 확장한 결과는 47-2 참고.
47-2. add/replace까지 확장 — LSTM-replace+area_delta가 전체 최저 FPE 달성
같은 area_delta feature로 MLP/LSTM × add/replace까지 전부 재학습 + closed-loop 재평가. 구성PG2만(CH46) val_acc+area_delta val_acc+area_delta SR/FPE MLP add 89.17% 89.37%(+0.20%p) — MLP replace 88.78% 88.98%(+0.20%p) — LSTM none 94.88% 95.08%(+0.20%p) 96.6% / 0.121m LSTM add 95.67% 95.67%(±0) 96.6% / 0.125m LSTM replace 95.47% 96.46%(+0.99%p) 96.6% / 0.098m ← 전체 최저 LSTM-replace + area_delta(0.098m)가 이 챕터 전체에서(기존 Kosmos-2 데이터 포함) 가장 낮은 FPE를 달성 — PG2-only replace(0.120m) 대비 18% 개선, 기존 Kosmos-2-none(0.101m)보다도 낮다. val_acc 개선폭도 6구성 중 가장 큼(+0.99%p) — hidden state를 bbox 32차원과 완전히 대체하는 replace 모드가 area_delta의 추가 정보를 가장 잘 활용한 것으로 보인다(bbox 채널이 없어서 area_delta 같은 보조 신호의 상대적 비중이 더 큼). CH47 최종 결론: CH46-5에서 발견한 "PG2가 정밀해지며 잃은 근접 신호"는 area_delta 하나로 상당 부분 복원 가능했고, 특히 LSTM-replace 조합에서는 기존 데이터보다도 더 나은 결과를 냈다. 다음 best 모델 후보: LSTM + replace + area_delta (val_acc 96.46%, closed-loop FPE 0.098m). ⚠️ 단, 이 수치는 매프레임 그라운딩(skip_n=1) 가정 — 운영 기본값 skip_n=3에서는 이득이 사라짐, CH49 참고. plans: plan_20260623_area_delta_proximity_feature.md | 2026-06-23
6/22 미팅 TODO "val 29개로는 SR 변별 안 됨, 어려운 path_type 분리 평가 필요"에 대응. SR은 전 모드 포화, replace mode가 전환 경로 FPE 40% 개선
52-1. 배경 — 6/22 미팅 TODO 대응
CH43-2c에서 "val 29개 에피소드로는 none/add/replace 간 SR 차이를 식별하기 어렵다 (천장 근처에서 전부 포화)"는 한계를 언급했고, 6/22 미팅 TODO로 "어려운 path_type만 분리 평가"가 남았었다. CH43-2d에서 5-seed 확대는 수행했지만(95.39%±0.20%p), path_type별 분리는 미착수 상태였다. 이번에 val 30개 에피소드 × 9 path_type (3~4개씩, stratified seed=42)에 대해 none/add/replace를 path_type별로 완전히 분리해 측정했다. 체크포인트: none → 이번에 새로 학습(val_acc 94.49%, bbox_dataset_full.json) / add/replace → CH43 원본(add 96.85%, replace 95.47%). 셋 모두 Kosmos2 주석 데이터로 학습·평가.
52-2. 결과 — SR은 모드 무관, FPE에서 replace가 우세
path_type n none SR / FPE add SR / FPE replace SR / FPE ── 직진 계열 ── center_straight 4 100% / 0.122m 100% / 0.163m 100% / 0.081m left_straight 3 100% / 0.159m 100% / 0.181m 100% / 0.243m right_straight 4 100% / 0.000m 100% / 0.000m 100% / 0.000m 직진 소계 11 100% / 0.088m 100% / 0.108m 100% / 0.096m ── 전환 계열 ── center_left 3 100% / 0.115m 100% / 0.153m 100% / 0.000m center_right 3 100% / 0.115m 100% / 0.000m 100% / 0.038m left_left 3 100% / 0.192m 100% / 0.140m 100% / 0.153m left_right 3 100% / 0.153m 100% / 0.145m 100% / 0.077m right_left 3 100% / 0.115m 100% / 0.048m 100% / 0.048m right_right ⚠️ 3 67% / 0.364m 67% / 0.380m 67% / 0.319m 전환 소계 18 94.4% / 0.176m 94.4% / 0.144m 94.4% / 0.106m 전체 29 96.6% / 0.142m 96.6% / 0.131m 96.6% / 0.102m
52-3. 해석
- SR: 세 모드 완전 동일 (96.6%) — path_type을 분리해도 none/add/replace 사이에 SR 차이가 없다. val 세트가 SR 기준으로 이미 포화(천장)임을 재확인. 9개 path_type 중 8개가 100%이고, 유일한 예외는 right_right(67%)인데 이것도 세 모드 모두 동일하게 실패 — 특정 에피소드가 어려운 것이지 hidden state 여부의 문제가 아님.
- FPE: replace가 전환 경로에서 유의미한 차이 — 전환 소계 기준 none 0.176m → replace 0.106m (40% 감소). add도 0.144m로 개선되지만 replace가 더 좋음. 직진 계열은 세 모드 간 차이 미미(0.088~0.108m 범위).
- right_right 구조적 약점 — 3개 에피소드 중 1개가 세 모드 모두 FPE 0.5m 이상(실패). 이 에피소드는 val split에 고정(seed=42)되어 있어, 모든 CH에서 동일하게 불리하게 작용 — 이 1건이 전환 계열 SR의 유일한 감점 요인이므로 이 에피소드를 따로 분석하면 실패 원인을 식별할 수 있을 것.
- 6/22 TODO 결론: "더 큰 표본·path_type 분리로 hidden state 효과를 검증"하라는 요청에 대해 — SR 기준으로는 효과 없음, FPE 정밀도 기준으로는 replace mode가 전환 경로에서 일관되게 유리. FPE 0.5m 성공 임계값 대비 세 모드 모두 충분히 안쪽이어서 실운용 차이는 없지만, 경로 추적 정밀도(FPE)를 우선시한다면 replace가 최선의 선택. CH52 결론 (6/22 미팅 TODO 완료) path_type 분리 평가로 "val 천장 포화" 가설 재확인 — SR은 어떤 path_type에서도 모드 간 차이 없음. Hidden state의 가치는 FPE 정밀도에 있으며, replace mode가 전환 경로에서 가장 우수(0.176→0.106m, ×1.7). right_right 실패는 에피소드-레벨 문제(모델 무관). 6/22 TODO #4 (path_type 분리) ✅ 완료. ※ 최신 기준: Exp66 LSTM w=16이 CL 96.6% / FPE 0.080m으로 현재 SOTA — replace mode의 FPE 개선 인사이트가 LSTM 설계에 기여한 것으로 봄. 현재 프로덕션 서버는 baseline head 배포 중 (replace 체크포인트 미배포). 스크립트: scripts/eval/closed_loop_eval_pathtype_breakdown.py | 데이터: docs/v5/closed_loop_eval/lstm_pathtype_breakdown.json | 2026-06-26
exp67(MLP) · exp71(Transformer) · exp72(cx-Geom) 3종 헤드를 PG448 어노테이션 기반으로 학습·CL 평가 (2026-07-01)
60-1. 배경 — 왜 헤드 ablation인가
CH59에서 PG448 검출률이 99.8%(vs PG224 95.9%)임을 확인했다. 그러나 기존 Stage2 MLP(exp65/66)는 PG224 어노테이션으로 학습된 상태였다 — 학습/추론 분포 불일치가 잠재적 병목. 동시에, 이산 액션 공간에서 히스토리를 flat-concat하는 MLP가 최선인지도 불명확했다. 시간적 순서(Transformer)나 현재 기하 정보의 명시적 분리(cx-Geom)가 더 유리할 수 있다는 가설을 검증한다.
60-2. 실험 설계
공통 조건: FrozenCLIPV2 (Kosmos-2 vision encoder, 256-dim), WINDOW=8, PG448 어노테이션(bbox_dataset_pg448_cx.json, 2567/2572=99.8% 검출). 실험 헤드 구조 아이디어 exp67 MLP flat FC 4-layer (288→256→128→64→8) exp66 구조 + PG448 어노테이션 교체 exp71 TransformerEncoder (d=260, nhead=4, 2층) + CLS token 히스토리를 시퀀스로 처리 → 순서·attention 활용 exp72 2-branch: temporal(288→128) + geom(4→32) → merge(160→64→8) 현재 프레임 cx/cy를 별도 기하 경로로 명시적 주입
60-3. cx-rule 기하학 오버라이드 — 효과 없음
이산 액션 경계에서 방향 전환이 늦는 경우를 개선하기 위해 cx-rule을 도입했다: bbox 중심 cx 값으로 모델 출력을 강제 오버라이드하는 룰. cx < 0.25 → ROT_L · <0.40 → FWD+L · ≤0.60 → FORWARD · ≤0.75 → FWD+R · >0.75 → ROT_R 결과: exp67(PG448 MLP) + cx-rule → CL SR 100% → 50%, FPE 0.02m → 0.41m 악화. MLP가 이미 cx를 히스토리 내부에서 잘 처리하고 있는 상태에서 룰이 오버라이드하면 오히려 방해가 된다. VLA_CX_RULE 기본값 off 유지.
60-4. Action Head Ablation 결과
실험 어노테이션 val_acc CL SR CL FPE 비고 exp65 (MLP) PG224 96.6% 0% — PG224 검출 실패로 collapse exp67 (MLP) PG448 96.8% 100% 0.02m PG448 교체만으로 CL 완전 회복 exp71 (Transformer) ⭐ PG448 97.6% 100% 0.00m val_acc+FPE 모두 best exp72 (cx-Geom) PG448 96.8% 100% 0.00m FPE=0.00m, 구조 단순해 soda 배포 유리 exp67 + cx-rule PG448 — 50% ↓↓ 0.41m ↑↑ 룰 오버라이드 역효과
60-5. 핵심 발견 요약
① 어노테이션 품질이 헤드 구조보다 결정적이다. PG224(95.9%) → PG448(99.8%)으로 교체만으로 CL SR 0% → 100%로 회복. 헤드 설계 전에 데이터 품질 병목 해소가 선행되어야 함. ② Transformer 헤드(exp71)가 val_acc·FPE 모두 최고. 히스토리를 시퀀스로 처리 + CLS attention → val_acc +0.8%p, FPE 0.00m 완전 수렴. 8/8 CL 에피소드 전승. ③ cx-Geom(exp72)도 FPE 0.00m — 단순한 기하 prior도 충분히 유효. TransformerEncoder 없이도 현재 프레임 cx를 명시적 경로로 주입하면 MLP 대비 동등한 CL 정확도를 달성. ④ cx-rule 룰 오버라이드는 역효과. 학습된 MLP가 이미 cx를 내재화한 상황에서 외부 룰이 간섭 → SR 반토막. 제거하고 VLA_CX_RULE=0 유지.
60-6. 다음 단계
- soda 실주행 CL — exp71(Transformer) 또는 exp72(cx-Geom) 체크포인트를 soda에 배포해 실환경 SR 측정.
- 데이터 추가 수집 — center/left/right 각 20개씩 → exp71 재학습 + 통계 강화.
- Phase E(논문) — decomposition + PG448 grounding + Transformer head 구조를 modular VLM 프레임워크로 정리. exp67: runs/v5_nav/mlp/exp67/action_mlp.pt | exp71: runs/v5_nav/mlp/exp71/action_transformer.pt | exp72: runs/v5_nav/mlp/exp72/action_cxgeom.pt | 어노테이션: docs/v5/bbox_frame_level/bbox_dataset_pg448_cx.json | 2026-07-01
60-7. 추론 시각화 — 대표 프레임별 3모델 비교
오버레이 범례: ■ PG448 bbox ┼ cx/cy 십자선 ● 히스토리 궤적(WINDOW=8) 우측 패널: exp67 MLP / exp71 Transformer / exp72 cx-Geom 각 softmax bar GT: FORWARD — cx≈0.41, basket 중앙 ↗ 원본 GT: FWD+L — cx≈0.61, basket 살짝 우측 ↗ 원본 GT: ROT_L — cx≈0.73, basket 극우 → 좌회전 ↗ 원본 GT: ROT_R — cx≈0.24, basket 극좌 → 우회전 ↗ 원본 GT: LEFT — cx≈0.52, 에피소드 초반 ↗ 원본 GT: RIGHT — cx≈0.50, 에피소드 초반 ↗ 원본 생성 스크립트: scripts/visualize_inference_exp67_71_72.py | Raw 이미지: GitHub Raw
62-1. 결정적 반례: grounding 성공 ≠ 액션 반응
2026-07-11 obj_right 11세션(유효)을 H5 raw 배열로 직접 대조. 세션결과첫 탐지 프레임회전 액션 낸 프레임 205228 실패 0 0,1,2,9 205354 성공 0 0,1,2 205621 성공 0 0,1,2 205726 성공 0 0,1,2,3,4 213650 실패 6 없음 213749 실패 3 없음 214155 실패 3 5 (1프레임뿐) 215709 실패 3 없음 220142 실패 6 없음 220233 실패 3 없음 220439 실패 없음(미탐지) 없음 성공 4개 전부 first_detect_frame=0, 실패 7개 전부 first_detect_frame≥3 또는 미탐지 — 완벽하게 갈린다. 회전 액션은 예외 없이 초반 0~4프레임에서만 나온다. 213650·220142는 grounding이 나중에(frame 6) 정확히 잡혔는데도(cx 0.73~0.76 연속) 회전 액션이 단 한 프레임도 없었다 — grounding 문제가 아니라 액션 헤드가 초반 window 이후 grounding 업데이트를 무시한다는 직접 증거.
62-2. 첫 탐지 성공했는데도 실패한 반례(205228) — 오버슈트 후 미회복
205228(실패)205354(성공)205621(성공)205726(성공) frame0 cx 0.730 0.706 0.711 0.711 f3~5 cx 0.318 (Δ0.41) 0.377 (Δ0.33) 0.465 (Δ0.25) 0.575 (Δ0.14) f6~8 cx 0.186 (계속 하강) 0.410 (반등) 0.437 (반등) 0.612 (반등) 재회전 시도 f9 (늦음, grounding 놓친 직후) 없음 없음 f4 미세보정 1회 마지막 유효 cx 0.082~0.112 (가장자리) 0.278~0.407 0.428~0.432 0.171~0.322 성공 케이스는 초기 회전 후 cx가 반등하며 중앙으로 재수렴한다. 205228은 초기 회전량이 과도해(vyaw=-1.15 3프레임 유지) cx가 반등 없이 계속 밀리고, 뒤늦은 재보정(f9)도 방향/타이밍이 어긋나 화면 가장자리로 빗나간 채 종료(오퍼레이터 메모: "살짝 엇나감").
62-3. 정량 검증: cx-액션 방향 일치율(VSC)이 우연 이하 — 라벨 자체의 confound
bbox_dataset_owl_150ep.json(147ep, 2559프레임)에서 방향성 액션(LEFT/RIGHT류)만 골라 sign(cx-0.5)(시각적 기대 방향)과 실제 라벨 방향의 일치율(VSC) 계산: cx 구간일치/전체VSC 0.15~0.30 26/55 47.3% 0.30~0.45 51/200 25.5% 0.45~0.55 88/192 45.8% 0.55~0.70 44/166 26.5% 0.70~0.85 26/49 53.1% 전체 235/662 35.5% 50%(우연)보다 낮다 — 라벨 방향이 시각적 cx 기대와 오히려 반대로 겹치는 경향이 있다. 원인: 액션 라벨은 "이 순간 물체가 화면 어디 있으니 이 방향으로 튼다"가 아니라 "사전에 정한 경로(path_type)를 재생한 기록"이기 때문 — 곡선 진입 중 회전 자체가 물체를 화면 반대쪽으로 밀어내는 motion parallax 효과까지 겹쳐 cx와 액션이 원래도 강하게 연결돼 있지 않다. 결론: 실시간 물리 드리프트로 cx가 바뀌어도 모델이 반응하지 않는 게 이상한 게 아니라 — 애초에 학습 라벨 자체가 "라이브 cx에 반응하는 제어기"가 아니라 "초반에 본 장면으로 경로 하나를 고르고 그 경로를 재생하는 함수"에 가깝게 구성돼 있다.
62-4. 오프라인 지표: 오버슈트 회복률 14.3%
cx가 방향 반전(|Δ|>0.03)하는 지점에서 이후 5프레임 이내 회전 액션이 나오는지 확인 (2026-07-11 obj_right 11세션): 오버슈트 이벤트 7건 중 회복시도 1건 = 14.3%. 성공 케이스의 반전은 근접 접근 중 측정 노이즈일 가능성이 있어 62-3(VSC)보다 노이즈에 민감한 보조지표로 취급.
62-5. 향후 시도 평가지표 (재수집/재학습 전후 비교용)
지표현재값목표
1 VSC(방향 일치율) 35.5% 전체 70%+ 2 오버슈트 회복률 14.3%(1/7) 유의미한 증가 3 Grounding-Action 반응 지연 사실상 무한 유한값 감소 4 first_detect_frame 무관 성공률 75%(0군) vs 0%(≥3군) 격차 축소 5 closed-loop obj_* 종합 성공률 34.7%(25/72) 유지/개선 지표 1·2는 재수집 없이 기존 학습 annotation만으로 오프라인 측정 가능 — 새 데이터의 "지시-경로 디커플링"이 confound를 실제로 끊었는지 로봇 재수집 전에 먼저 검증 가능. 결정 완료(2026-07-12): §61-16 오프라인 완화책 (재가중치/hybrid rule)이 전부 무효로 재확인됨에 따라, 트랙C(오버슈트→재수렴, 64ep)를 신규 필수 트랙으로 확정 — 극단cx 위치 4곳 × 오버슈트방향 2종 × 8회. 초반 1회 회전 데이터를 빼는 것은 비권장 — 그 패턴 자체가 문제가 아니라 "그 패턴만 있다"는 다양성 부족이 문제이므로, 삭제보다 추가가 맞는 방향. 상세는 docs/plans/plan_20260707_heterogeneous_instruction_extreme_cx_collection.md §1 "트랙 C" 참고. 전체 상세: CH62_FORWARD_LOCK_AND_LABEL_CONFOUND.md | 이미지 비교(bbox/cx 오버레이): 로컬 리포트 docs/v5/analysis_reports/ch61_forward_lock_20260712.html
62-6. 거리축(area) confound — 근접해도 STOP 없음, 방향축과 별개 문제
2026-07-12 신규 세션 215344 raw 대조(94스텝): area가 0.06→1.0(완전 근접)→0.06으로 3~4차례 왕복하는 동안 grounding은 이 왕복을 잘 추적하는데도 FORWARD 88/94(93.6%), STOP 0회 — area=1.0(화면을 거의 채운 근접 상태)에서도 정지 신호 없음. cx도 극단(0.877→0.95)까지 튀는데 FORWARD 유지 — 62-1·62-3의 방향축 confound와 정확히 같은 구조가 거리축에도 독립적으로 존재함을 보여주는 반례. 단, 방향축 문제와는 원인이 다르다: STOP은 애초에 학습 데이터에 "에피소드 끝 프레임 합성" 라벨뿐이라 실제 근접-정지 신호 자체가 원천 부재 — 트랙A/C(방향 다양화)로는 해결 안 됨. 확장 옵션을 정리: 방향내용비용/위험 트랙D(근접정지 신규 수집) area 임계치별(0.7/0.85/1.0) 실제 근접-정지 궤적 수집 물리수집 추가 필요 AVSC(거리축 VSC) area↑→STOP/후진 일치율을 62-3처럼 정량화 기존 annotation으로 오프라인 즉시 가능 서버 룰 오버라이드 area≥임계치일 때 강제 STOP (안전장치, 코드만 변경) §61-16 hybrid rule과 같은 종류 완화책 — 방향축에서 무효였던 전례, 안전용 임시책으로만 고려 결론: STOP을 룰로 임시 처리하더라도 exp72(트랙A/C 재학습)의 범위·필요성은 그대로 유지 — 방향축(VSC/오버슈트회복률)과 거리축(STOP/근접)은 독립된 별개 confound이며, 이번 캠페인은 방향축만 타겟한다. 트랙D/AVSC는 범위 확정 전 백로그로 별도 기록.
62-7. ROT_L/R(제자리 회전 재센터링) — 희소 클래스, 백로그 (2026-07-15 결정)
2026-07-15 Track A weak_right::left_curve 15ep(1194프레임) 품질 체크 중 확인: 근접
상황에서 바구니 중심을 맞추려 제자리 회전(ROT_L/R)하는 장면이 실제 존재하나, 8-class
분포상 ROT_L 0.3%(4/1194), ROT_R 0.3%(3/1194)로
극히 희소 — 기존 V5 150ep 분포(각 ~0.8%)와 동일한 수준. 이 비율로는 cross-entropy
학습에서 그래디언트 기여가 사실상 없어 모델이 해당 행동 자체를 못 배울 가능성.
오프라인 오버샘플링(class-weight)은 기각: exp71에서
이미 reweight 설정을 방향축 confound 완화책으로 시도했으나 무효 확인됨
(confound_mitigation_20260710.json) — 같은 방식이 이 축에서도 통할 근거 없음.
대신 트랙D(거리축)와 같은 방식으로, 근접-재센터링(ROT_L/R)
전용 물리 수집을 별도 소규모 트랙(가칭 Track E, 15~20ep)으로 신규 확보하는
쪽이 현실적 대안.
결정: Track A(180ep)/Track C(64ep) 물리 수집을
우선 완료 후 재검토. Track E는 트랙D/AVSC와 함께 범위 확정 전 백로그로 기록.
63-1. 전체 순위 — mlp가 1위권, 배포 아키텍처(transformer)가 최하위권
조합meanstdbest owl/v6(180ep)/cxgeom 78.1% 0.1 78.2% pg448/v6(180ep)/mlp 77.9% 0.2 78.0% owl/v6(180ep)/mlp 77.7% 0.2 78.0% pg448/v6(225ep,+트랙F)/mlp 77.4% 0.4 77.9% pg448/v6(180ep)/cxgeom 77.7% 0.1 77.8% pg448/v6v5(혼합)/cxgeom 77.0% 0.5 77.7% owl/v6(225ep)/mlp 76.7% 0.4 77.1% pg448/v6v5/mlp 77.0% 0.2 77.1% pg448/v6(225ep)/cxgeom 76.2% 0.3 76.6% owl/v6(225ep)/cxgeom 75.8% 0.1 76.0% pg448/v6(180ep)/contreg 75.2% 0.6 75.9% owl/v6(180ep)/transformer 74.9% 0.7 75.9% owl/v6(180ep)/contreg 74.4% 0.6 75.1% pg448/v6(180ep)/transformer(배포 아키텍처) 74.5% 0.4 74.9% pg448/v6(225ep)/contreg 74.0% 0.5 74.7% owl/v6(225ep)/contreg 74.0% 0.3 74.4% pg448/v6v5/transformer 72.9% 0.5 73.7% owl/v6(225ep)/transformer 71.8% 0.4 72.3% pg448/v6(225ep)/transformer 71.8% 0.2 72.0% pg448/v6(225ep)/flow(MoNa-pi 경량판) 71.2% 0.8 72.0% owl/v6(225ep)/flow(MoNa-pi 경량판) 71.1% 0.3 71.3% (전체 최하위)
63-2. V5 혼합(v6v5)은 전 헤드에서 손해 — 시간축 이질성 확정
V5(키프레임 ~17프레임/ep, STOP 라벨 없음)를 V6(6.2Hz 연속, STOP 8.4%)에 섞은 v6v5 arm은 transformer -1.6%p, mlp -0.9%p, cxgeom -0.7%p — 예외 없이 v6 단독보다 하락. window=8이 V5에선 에피소드 절반(~7초) 히스토리, V6에선 1.3초 히스토리를 의미하는 시간축 불일치가 실측으로 확정됨(§0 사전 예측과 일치). V6를 메인으로 갈 경우 V5 혼합은 배제.
63-3. 트랙F(center 45ep) 추가 — val 난이도 상승, mlp만 안정적으로 버팀
트랙A(180ep, 4극단위치만)에 트랙F(center, 45ep)를 더해 V6를 225ep로 완결한 뒤 재학습 — val_acc가 전 헤드에서 하락했으나 이는 성능 저하가 아니라 center 근처(방향 판단이 애매한 구간)가 처음으로 val에 포함되며 더 정직한(어려운) 검증셋이 된 것으로 해석. 헤드180ep best225ep best변화 mlp 78.0% 77.9% -0.1%p (거의 무영향) cxgeom 77.8% 76.6% -1.2%p contreg 75.9% 74.7% -1.2%p transformer(배포) 74.9% 72.0% -2.9%p (가장 크게 흔들림) mlp가 압도적으로 강건 — center 데이터 추가에도 거의 흔들리지 않음. 반면 배포 중인 transformer가 가장 취약한 조합일 가능성.
63-4. V6 위치별 8-class 분포 — 좌우 대칭 확인, center는 회전 거의 0%
트랙A+F(225ep, 16,599프레임) 전체를 위치별로 집계. 위치NSTOPFLRFLFRROT_LROT_R weak_right 3268 9.1% 39.7% 0.6% 9.5% 15.0% 23.4% 1.9% 0.8% strong_right 3602 8.0% 40.9% 0.2% 11.2% 17.9% 19.9% 1.8% 0.1% weak_left 3299 8.6% 49.4% 7.8% 0.7% 15.0% 16.6% 0.1% 1.8% strong_left 3611 8.6% 50.6% 9.9% 0.6% 11.5% 17.1% 0.2% 1.5% center(신규) 2819 9.6% 50.1% 2.7% 3.5% 17.3% 16.6% 0.0% 0.1% right 위치는 R/FR 우세, left 위치는 L/FL 우세로 좌우 대칭 확인(설계대로). center는 L/R이 둘 다 낮고(2.7%/3.5%) FL/FR이 균형(17.3%/16.6%) — 중앙 시작이라 큰 방향 보정 없이 대각선 접근이 주를 이룸. ROT_L/R은 center에서 사실상 0% ([[62-7 근접-재센터링 백로그]]와 별개로, center 위치 자체는 회전 필요성이 낮음을 시사).
63-5. 그라운더(PG448 vs OWL-v2)는 헤드·arm 대비 부차적 변수
같은 헤드·arm 내에서 그라운더 교체 시 격차가 대부분 1%p 이내(예: v6(180ep)/mlp pg448 77.9% vs owl 77.7%, v6(225ep)/cxgeom pg448 76.2% vs owl 75.8%) — CH60/61에서 확인된 "그라운더보다 확인해야 할 다른 축이 더 크다"는 패턴이 헤드 선택 축에서도 재확인됨. 그라운더 교체는 비용 대비 개선폭이 작아 우선순위가 낮음.
63-6. MoNa-pi(π0 계열) 비교 — 연속/flow 헤드가 이 규모에서 이산 헤드를 못 이김
자매 프로젝트 MoNa-pi(Flow Matching + AdaLN-Zero, 별도 π0 계열 VLA)의 실측 결과: closed-loop Success@0.5m 45.8%(FPE 0.823), 약점은 center_left 0%, center_right 33% — 우리 CH62 결론(헤드 구조보다 라벨/데이터 confound가 원인)을 독립적으로 재현. 본 세션에서 그 가설을 직접 검증하고자 rectified-flow 경량판(velocity field 예측 + 10-step Euler 적분, MoNa-pi AdaLN-Zero의 축소판)을 exp73에 4번째 연속계열 헤드로 추가: 헤드best(225ep,pg448) mlp(이산, 1위) 77.9% cxgeom(이산) 76.6% contreg(연속, 단일회귀) 74.7% transformer(이산, 배포) 72.0% flow(연속, MoNa-pi 경량판) 72.0% (owl 71.3%) 이 데이터 규모(225ep)에서는 연속/flow 계열이 이산 분류(mlp/cxgeom)를 못 이김 — flow의 ODE 적분·velocity field 학습이 주는 이점보다 소규모 데이터에서의 최적화 난이도가 더 크게 작용하는 것으로 보임. MoNa-pi 원본은 별도 데이터(92ep train)·풀 AdaLN-Zero로 45.8% closed-loop를 냈으므로 직접 비교는 아니지만, "헤드를 연속/flow로 바꾸면 저절로 좋아진다"는 가설은 이번 규모에서 기각 — CH62 결론(데이터 confound가 우선)이 헤드 선택 축에서도 다시 확인됨.
⚠️ 63-11. [정정] 63-8~63-10 closed-loop 수치 전부 오염됨 — val split 버그, 실제 순위 뒤바뀜 (2026-07-19)
버그: evaluate_closed_loop_exp73.py의 val_split()이 np.random.RandomState(42)(레거시 API)를 사용했는데, 학습 스크립트(train_exp73_trackA_heads.py)는 np.random.default_rng(42)를 사용함 — 같은 seed=42라도 완전히 다른 셔플 순서가 나온다. 그 결과 "val 33ep" 중 27ep가 실제로는 학습에 쓰인 데이터였음(6ep만 진짜 겹침) — 63-8/63-9/63-10에서 보고한 모든 closed-loop 수치(FPE/TLD/Success)가 held-out이 아니라 대부분 train 데이터로 측정된 것. np.random.default_rng()로 통일해 수정 후 진짜 held-out 33ep로 exp73 전 체크포인트(mlp/cxgeom/transformer/hybrid × pg448/owl × trackF유무/v6v5)를 재평가: 구성offline val_accFPE(m)Success@0.5m비고 pg448/v6/mlp (트랙F 없음) 85.3% 0.825 60.6% 신규 1위 pg448/v6v5/mlp 83.6% 1.055 57.6% owl/v6/mlp 85.5% 0.900 54.5% owl/v6/cxgeom, pg448/v6/cxgeom 83~85% 0.90~0.95 54.5% pg448_trackF/v6/hybrid (구 "최종 1위") 78.5% 1.082 39.4% 84.8%→39.4% 급락 pg448_trackF/v6/mlp (구 63-8 "1위") 78.3% 1.001 48.5% 72.7%→48.5% transformer 전 조합(배포 아키텍처) 72~75% 1.37~2.07 12~30% 최하위권 결론은 유지 뒤집힌 결론: (1) hybrid가 최종 1위가 아니라 트랙F 없는 평범한 mlp(트랙A 180ep 단독)가 60.6%로 실제 1위 — hybrid의 6-way/az 분리 구조가 오히려 일반화에는 더 취약했을 가능성(디자인 자체가 held-out에서 손해를 보는 방향인지는 재검증 필요). (2) 63-8에서 "트랙F 추가가 closed-loop를 개선한다"고 봤던 것도 반대 — 트랙F(center 45ep) 추가가 mlp/cxgeom 성능을 오히려 낮춤(60.6%→48.5%, 54.5%→36.4%). center 커버리지가 offline 강건성엔 도움이 되지만(63-3) closed-loop 일반화엔 손해일 수 있음 — 원인 미규명. (3) transformer 최하위권 결론만 유지됨. 남은 미세 불일치(경미, 원인 미규명): 수정 후에도 학습 스크립트가 기록한 offline val_acc(mlp 78.0%)와 이 재평가 스크립트가 계산한 val_acc(85.3%)가 정확히 일치하진 않음(hybrid는 78.1%/78.5%로 거의 일치) — 두 스크립트의 윈도우 구성 방식 차이일 가능성, closed-loop 결론 자체(순위·success)에는 영향 없다고 판단해 이번 라운드에서는 보류. 영향받는 후속 조치: 이 세션에서 완료했던 "B. 추론 서버 통합"(GoalNavMLPInference에 exp73_hybrid variant 추가)은 잘못된 승자 기준으로 선택된 것 — 코드 인프라(variant 확장 메커니즘) 자체는 재사용 가능하나, 실제 배포 후보는 hybrid가 아니라 pg448/v6/mlp(트랙F 없음)로 재검토 필요. soda에 전달했던 "hybrid 최종 1위" 메시지도 정정 필요(§DoD/soda 동기화 참고).
63-8. closed-loop(FPE/TLD/Success) 사전검증 — mlp가 offline·closed-loop 양쪽 모두 1위
⚠️ 아래 수치는 val split 버그로 오염됨 — 정정된 결과는 위 63-11 참고. 63-7의 "val_acc만으로 결론 내지 말라"는 원칙에 따라, exp73_v6_vis_cache(이미 인코딩된 vis+bbox)를 재사용해 window=6/bbox_scale=3.0 피처로 val 33ep에 대해 실제 궤적을 구성(scripts/sim/evaluate_closed_loop_exp73.py)하고 FPE/TLD/Success@0.5m을 측정했다. CH62의 exp11(PM 58.6%, CL 0%)·step2(75.9%, CL 66.7%) 사례와 apples-to-apples로 비교 가능. 구성val_acc(offline)FPE(m)TLDSuccess@0.5m pg448_trackF/v6/mlp(225ep, 최종 추천 구성) 77.9% 0.345±0.447 0.996 72.7% owl/v6/cxgeom(180ep, offline 1위 78.2%) 78.2% 0.802±0.774 1.003 48.5% pg448/v6/mlp(180ep, 트랙F 미포함) 78.0% 0.569±0.646 0.979 63.6% pg448/v6/cxgeom(180ep, 동일 그라운더 대조군) 77.8% 0.711±0.939 0.975 57.6% (참고) CH62 exp11 / step2 58.6% / 75.9% 1.45 / 0.55 — 0% / 66.7% 핵심: offline 1위(cxgeom 78.2%)가 closed-loop 최하위(48.5%) — offline 격차 0.3%p(77.9 vs 78.2)가 closed-loop에서 24%p 격차(72.7 vs 48.5)로 벌어짐. 동일 그라운더(pg448/v6) 내 대조에서도 mlp(63.6%)가 cxgeom(57.6%)을 앞서 — 헤드 랭킹은 offline 지표만으론 확정 불가하며 cxgeom의 "geometric branch가 최근 프레임에 과의존"하는 구조가 오차 누적에 더 취약할 가능성. 트랙F(center) 추가가 mlp 구성의 closed-loop도 개선(FPE 0.569→0.345, Success 63.6%→72.7%) — 63-3의 offline 강건성(-0.1%p)이 closed-loop에서도 재현됨.
63-9. lx/ly는 이미 이산, az만 진짜 연속 — hybrid(6-way lat/fwd + 연속 az) 헤드 신규 구현
⚠️ "최종 1위"였던 closed-loop 84.8%는 val split 버그로 오염된 수치 — 정정 결과(진짜 39.4%, 순위 하락)는 위 63-11 참고. lx/ly 이산·az 연속이라는 진단 자체와 HybridHead 구조는 유효, 성능 우위 결론만 철회. 63-6 이후 "연속 헤드로 정의 자체를 바꿀 수 있는가"를 검토하며 225ep 원본 raw 액션(lx,ly,az)의 실측 고유값 분포를 직접 스캔했다. 결과: lx, ly는 정확히 {-1.15, 0, +1.15} 3값만 존재(연속 신호가 아예 없음 — 수집 대시보드(mona_dashboard.py)가 아날로그 축을 _axis_to_key()로 8방향 키에 고정속도 매핑하기 때문), 반면 az는 33개+ 서로 다른 실측값을 가진 진짜 연속 신호(우측 스틱 raw 값이 그대로 보존됨). 즉 기존 8-class 정의가 "이산 신호(lx,ly)"와 "연속 신호(az)"를 하나의 분류기에 억지로 섞고 있었다는 뜻. 이에 따라 HybridHead를 신규 구현: lx,ly만으로 결정되는 6-way 분류(STOP/F/L/R/FL/FR, cross-entropy) + az 연속 회귀(MSE, tanh 출력) 두 브랜치를 공유 trunk 위에 얹고, 추론 시 6-way 예측이 STOP이면서 |az_pred|>0.1일 때만 ROT_L/R로 override하는 규칙(원본 nav_h5_dataset_impl.py 임계값과 동일)으로 최종 8-class 결합. 구성val_acc(offline)FPE(m)Success@0.5m pg448_trackF/v6/hybrid (신규, 최종 1위) 78.1% 0.274±0.353 84.8% pg448_trackF/v6/mlp (이전 1위) 77.9% 0.345±0.447 72.7% owl/v6/cxgeom (offline 역대 최고 78.2%) 78.2% 0.802±0.774 48.5% offline 지표로는 hybrid(78.1%)가 mlp(77.9%)보다 근소 우위(+0.2%p)에 불과하지만 closed-loop에서는 FPE 0.345→0.274m, Success 72.7%→84.8%로 격차가 크게 벌어짐 — "신호의 실제 성질(이산 vs 연속)에 맞게 헤드 출력 공간을 분리"하는 것이 단일 8-class 분류보다 오차 누적에 훨씬 강건함을 시사. lx/ly를 무리하게 연속으로 취급한 이전 contreg/flow 헤드(63-6, 71~75%)가 부진했던 이유도 이걸로 설명됨 — 애초에 없는 연속 신호를 만들려다 학습만 어려워진 것.
63-10. 연속 az를 궤적에 그대로 적분 → 오히려 악화 (부정 결과, az_thresh 스윕은 안정)
⚠️ 최초 측정치(discrete 84.8%/continuous 48.5%)는 63-11 val split 버그 영향권. 수정된 split으로 재검증한 결과 discrete(39.4%) > continuous(33.3%) 상대적 순위는 그대로 유지 — "discrete 결합이 낫다"는 결론 자체는 유효, 절대 수치만 하향 정정. 63-9의 hybrid_combine()은 6-way 예측이 STOP일 때만 연속 az_pred를 ROT_L/R 이산 클래스로 "되돌려" 평가한다 — hybrid의 연속 회귀 출력을 궤적 적분에는 전혀 못 쓰는 셈. 실기 배포라면 cmd_vel.angular.z에 연속값을 직접 실을 수 있으므로, "그렇게 하면 더 정밀한 회전 보정이 가능해 FPE가 더 줄지 않을까"를 검증했다. evaluate_closed_loop_exp73.py에 --az-mode {discrete,continuous} 추가: continuous 모드는 6-way 클래스의 (lx,ly) 고정값은 그대로 쓰되 az만 매 프레임 모델의 연속 예측값(az_pred×1.15)을 직접 적분. az 모드FPE(m)TLDSuccess@0.5m discrete (기존, thresh 0.05~0.2 전부 동일) 0.269~0.274 1.003 84.8% continuous (thresh 무관 동일) 0.885±0.821 1.003 48.5% 원인 추정: az_head는 STOP 프레임에서의 회전 의도만 정확히 맞히면 되도록 학습됐지, FORWARD/LEFT/RIGHT 등 비-STOP 프레임에서도 "진짜 0"을 정밀 회귀하도록 압박받지 않았다 — 그런 프레임에서 나오는 작은 az_pred 잡음이 (기존엔 discrete 결합으로 자동 0 처리됐던 것이) continuous 모드에서는 매 스텝 그대로 적분되어 헤딩 드리프트로 누적된다. 즉 discrete 결합이 우연이 아니라 "클래스가 회전 의도가 없을 때 az를 0으로 강제 클램프하는" 암묵적 정규화 역할을 하고 있었던 것. az_thresh(0.05/0.1/0.2 → 0.1/1.15 정규화)는 discrete·continuous 두 모드 모두에서 결과가 사실상 불변(±0.005m, success 동일) — STOP↔ROT 전환 임계값 자체는 민감하지 않음을 확인. 결론: 84.8% 배포 시에도 az_mode=discrete 그대로 유지. 연속 az 회귀를 궤적에 직접 쓰려면 non-STOP 프레임에서도 az≈0을 명시적으로 학습(예: 보조 손실)해야 할 것 — 향후 여지로만 기록. ⚠️ 시드 분산은 미확인: 학습 스크립트가 3-seed 중 best-of-3 체크포인트만 저장하므로 (offline val_acc는 77.0/78.1/78.0%로 seed 간 안정 확인됨), closed-loop 상의 seed 분산은 3-seed 전체를 별도 저장해 재평가해야 확인 가능 — 배포 결정을 바꿀 정도는 아니라 판단해 이번 라운드에서는 보류.
63-12. Action-chunk 헤드(ACT식 temporal ensembling) — 앙상블 자체는 +3pp 유효, 그러나 mlp보다 낮음
63-11 정정 후 재확인한 실패 패턴(청크 최빈값 acc≈프레임 acc — 오류가 국소적이지 않고 구간 전체에 걸쳐 일관되게 틀림, 즉 "구간형 방향 오판")에 착안해 ActionChunkHead를 신규 구현: window=6 컨텍스트로 향후 K=4프레임(offset 0~3)의 8-class 액션을 동시 예측(mlp와 동일 trunk), 추론 시 서로 다른 시점에서 겹쳐 예측한 청크들의 softmax 확률을 균등 평균해 최종 결정(ACT의 temporal ensembling과 동일 원리). 구성offline val_accFPE(m)Success@0.5m chunk, 앙상블 없음(offset-0만) 77.1% 1.098 39.4% chunk, 앙상블 적용 76.6% 1.158 42.4% (+3pp) mlp (트랙F 없음, 현 1위) 85.3% 0.825 60.6% 결론: 앙상블 자체의 방향은 가설대로 맞았다 (39.4%→42.4%, 구간형 오류가 겹친 예측 평균으로 일부 상쇄됨). 하지만 chunk 헤드는 offline val_acc부터 mlp보다 8.7%p 낮음(77.1% vs 85.3%) — 같은 크기 trunk(512→128)를 4개 시점에 동시에 나눠 쓰다 보니 단일 프레임 전용 헤드보다 용량이 희석된 것으로 추정. 시사점: temporal ensembling 아이디어는 "새 헤드 구조"가 아니라 기존 챔피언(mlp)의 추론 단계에 후처리로 적용하는 쪽이 더 유망 — 63-13에서 검증.
63-13. mlp에 인과적(과거만) temporal smoothing 후처리 — 단조 악화, 63-12와 반대 결론
63-12의 시사점("앙상블을 mlp 후처리로 적용")을 실제로 검증. mlp(트랙F 없음, 현 champion)의 프레임별 softmax를 인과적(미래 프레임 사용 안 함) 이동평균으로 스무딩 후 argmax — 실기 배포에서도 그대로 재현 가능한 후처리(과거 프레임만 사용). smooth_windowval_accFPE(m)Success@0.5m 1(미적용, 현 baseline) 85.3% 0.825 60.6% 3 83.2% 0.874 54.5% 5 80.6% 0.993 42.4% 7 77.9% 1.069 30.3% 9 75.5% 1.131 18.2% 결론(부정적, 명확): 윈도우가 커질수록 성능이 단조 하락 — 스무딩을 아예 안 쓰는 게 최선. 63-12의 청크 앙상블과 원리가 다르다는 게 핵심: 청크 앙상블은 "같은 시점"에 대한 여러 독립적(서로 다른 관측 윈도우에서 나온) 예측을 평균한 것인 반면, 이 causal smoothing은 "서로 다른 시점"의 예측을 평균하는 것 — 방향이 실제로 바뀌는 전환 구간(직진→회전 등)에서 과거 쪽 예측이 아직 이전 방향을 담고 있어 반응 지연(lag)만 생기고, 이 지연이 궤적 적분에서 그대로 누적 오차가 됨. 즉 "여러 시점 평균이 항상 좋다"가 아니라 "무엇을 평균하는지"가 핵심 — 청크처럼 미래를 내다본 예측끼리 평균하는 것과, 과거 예측을 그대로 끌어와 평균하는 것은 다른 효과. 실전 시사점: mlp는 후처리 스무딩 없이 그대로 배포가 맞다 — 방향 전환 반응 속도가 이미 이 태스크에서 핵심 강점인데, 스무딩이 그걸 깎아먹는 트레이드오프.
⚠️ 63-14. mlp(현 champion) closed-loop 3-seed 분산 — 재현성 낮음, 60.6%는 낙관적 표본일 가능성
63-11 정정 후 "진짜 1위"로 확정한 pg448/v6/mlp(트랙F 없음)의 3-seed 전체를 별도 저장해 개별 closed-loop 검증 (63-11 DoD에서 미뤄뒀던 항목). 동일 코드·동일 seed(0,1,2)로 재학습: 체크포인트offline val_accFPE(m)Success@0.5m seed=0 (재학습) 77.4% 1.026 33.3% seed=1 (재학습) 76.9% 1.032 36.4% seed=2 (재학습) 78.3% 1.001 48.5% 기존 "best" 체크포인트(저장된 offline 78.0%) 78.0% 0.825 60.6% 문제: offline val_acc는 4개 체크포인트 전부 76.9~78.3%로 거의 동일한데, closed-loop Success는 33.3%~60.6%로 거의 2배 차이가 남. 기존 "best" 체크포인트는 원래 학습 실행(main() 3-seed 중 하나)에서 나온 것으로 보이지만 이번에 "동일 seed"로 재학습해도 재현이 안 됨 — GPU 비결정성(cudnn 알고리즘 선택 등)으로 같은 seed라도 완전히 같은 가중치가 나오지 않고, val 33ep라는 작은 표본에서 FPE 0.5m 경계 근처 에피소드 몇 개의 성패가 뒤집히면 success%가 크게 흔들리는 구조. 해석: 60.6%는 "진짜 1위"라기보다 이 아키텍처/데이터 조합이 낼 수 있는 성능 분포의 낙관적 꼬리(33~60% 범위 중 상단)로 봐야 함 — 33ep 표본과 GPU 비결정성이 만든 노이즈 폭이 서로 다른 헤드/구성 간 비교(63-11 리더보드)의 순위 신뢰도 자체를 약화시킴. hybrid(39.4%)·chunk(42.4%)·mlp(33.3~60.6%) 구간이 실제로 겹칠 가능성이 있다는 뜻. 권고: 앞으로 exp73류 closed-loop 비교는 단일 체크포인트 1회 평가가 아니라 최소 3-seed × 평균/분산으로 보고해야 함(트랙C 289ep 재학습 시 §D 런북에 반영 필요). val 33ep 자체도 작아서(전체 225ep의 15%) 트랙C 추가로 289ep가 되면 표본이 늘어 분산이 다소 줄어들 것으로 기대.
🚨 63-15. [재정정] 63-14 분산의 진짜 원인 발견 — CACHE_V6 재빌드로 "v6" arm이 트랙F를 몰래 포함, 60.6%는 OOD 오염 착시였음 (2026-07-22)
63-14에서 "60.6%는 낙관적 표본"이라 정리했지만, 실제 원인은 GPU 비결정성이 아니라 데이터 조건 자체가 달랐던 것으로 확인됨. 학습 로그를 대조한 결과: - exp73_train_pg448.log(champion, "pg448/v6" 원본): encoded N/180 — 트랙A 180ep만으로 학습 - exp73_train_trackF_pg448.log("pg448_trackF/v6"): encoded N/225 — 트랙A+F 225ep로 학습 즉 CACHE_V6(exp73_v6_vis_cache.pt) 파일이 트랙F 수집 이후 180ep → 225ep로 덮어써졌고, 코드의 arm="v6"는 "현재 캐시 전체"를 의미할 뿐 "트랙A만"을 뜻하지 않음. 그 결과 closed-loop 재평가(및 63-14의 seed 재학습) 모두 225ep 풀에서 val 33ep를 뽑았는데, 그 중 7개(21%)가 center_(트랙F) 에피소드 — champion 체크포인트(180ep 학습, 트랙F를 단 한 프레임도 본 적 없음)에게는 완전히 분포 밖(OOD) 데이터로 평가된 것. train_exp73_trackA_heads.py/evaluate_closed_loop_exp73.py에 --exclude-trackf 플래그를 추가해(center_ 필터링 후 분할) 원래 조건(180ep)을 재현, champion 체크포인트를 올바른 180ep-only val(27ep)로 재평가: 체크포인트평가 조건Success@0.5m champion(=seed0, 180ep 학습) 225ep val(오염, 기존) 60.6% (착시) champion(=seed0), 재평가 180ep val(정정, 27ep) 25.9% seed1 (180ep 재학습) 180ep val(정정) 33.3% seed2 (180ep 재학습) 180ep val(정정) 33.3% pg448_trackF/v6/mlp(225ep 학습·평가, 내적 일관) 225ep val(정합) 48.5% 뒤집힌 결론(2회차): (1) champion(180ep-only)의 진짜 성능은 25.9~33.3%(seed 재현성은 오히려 양호, GPU 비결정성 기여는 크지 않음) — 60.6%는 순전히 OOD 오염 착시였음. (2) 63-11의 "트랙F 추가가 closed-loop를 오히려 낮췄다"는 결론도 이 착시 위에 세워진 것 — apples-to-apples로 다시 보면 트랙F 포함 학습(48.5%)이 트랙A-only(25.9~33.3%)보다 확실히 낫다. 트랙F(center) 데이터가 실제로는 일반화에 도움이 됐는데, 오염된 비교 때문에 정반대로 결론 내렸던 것. 최종(3회차) 정정: 배포 후보는 pg448_trackF/v6/mlp (225ep, Success 48.5%) — 지금까지 나온 exp73 전 조합 중 apples-to-apples로 검증된 진짜 최고 수치. hybrid(39.4%, 동일 225ep 조건)보다도 우위 유지. 교훈: 공유 캐시 파일(CACHE_V6)을 실험 중간에 덮어쓰면, "같은 arm 이름"이 시점에 따라 다른 데이터를 가리키게 되어 재현성이 통째로 깨진다 — 데이터 버전을 코드가 아니라 사람이 암묵적으로 관리하고 있었던 게 근본 원인. 향후 캐시 파일은 버전 접미사(예: _180ep, _225ep)를 붙여 불변으로 관리 권장.
📊 63-16. 통일 비교표 (apples-to-apples) — 전 조합 225ep 학습·225ep val 재평가 + seed 분산 (2026-07-22)
63-15에서 드러난 조건 혼입을 청산하기 위해, 모든 헤드를 동일 데이터(225ep=트랙A+F)로 학습하고 동일 225ep val로 재평가한 통일표. 이전 리더보드(63-11)에 남아있던 stale JSON(hybrid 84.8% 등, 옛 버그값이 az-suffix 파일에 방치돼 있던 것)을 전부 폐기하고 신선 재평가로 대체. 2 그라운더(pg448/owl) × 5 헤드(mlp/cxgeom/transformer/hybrid/chunk). contreg/flow는 회귀헤드라 closed-loop 스크립트 미지원 → 제외(offline 최하위권으로 이미 결론). config (grounder/head, 225ep)Success@0.5mFPE(m)offline pg448/mlp 48.5% (best-of-3) 1.001 78.3% owl/mlp 48.5% 0.998 77.6% pg448/chunk 42.4% 1.158 76.6% owl/hybrid 42.4% 1.061 77.5% pg448/hybrid 39.4% 1.082 78.5% pg448/cxgeom, owl/cxgeom, owl/chunk 36.4% 1.07~1.20 76~77% pg448/transformer 27.3% 1.366 72.6% owl/transformer 18.2% 1.370 72.8% 챔피언 seed 분산(pg448/mlp, 225ep, 3-seed): closed-loop Success = 33.3 / 36.4 / 48.5% (평균 ~39.4%, std ~6.5%p) — 헤드라인 48.5%는 사실 best-of-3(seed2)였음. 핵심 결론 3가지: 1) 그라운더(pg448 vs owl)는 사실상 무차별 — mlp에서 48.5%로 동률, 다른 헤드도 ±6%p 내. 실기에서 어느 그라운더를 쓰든 큰 차이 없을 것(61-18의 "그라운더 교체는 무효" 실기 결론과 일치). 2) 헤드 상위권(mlp·chunk·hybrid)은 통계적으로 구분 불가 — mlp 39.4±6.5%, chunk 42.4%, hybrid 39.4%가 seed 노이즈 폭 안에서 겹침. "어느 헤드가 최고냐"를 val 33ep로는 못 가림. 단 transformer(18~27%)는 확실히 최하위 — 이건 노이즈로 설명 안 되는 실질적 열위(배포 중인 아키텍처라 교체 근거). 3) 지금 병목은 헤드/그라운더가 아니라 표본 크기 — 33ep val로는 상위 조합을 못 가리므로, 새 헤드/그라운더 추가는 수확체감. 트랙C(64ep)로 표본을 289ep까지 늘려 val을 키우는 게 유일하게 순위를 신뢰 가능하게 만드는 길. 배포 후보(4회차 확정): pg448_trackF/mlp 또는 owl_trackF/mlp — 둘 다 48.5%(best), 평균 39.4%. mlp가 가장 단순하고 상위권과 동률이라 실기 우선 후보로 유지. 단 실기 테스트는 반드시 여러 회 반복(seed·비결정성 노이즈가 ±6%p이므로 1회 결과 신뢰 금물).
63-7. 결론 및 다음 단계 [2026-07-22 재정정 — 3회차]
⚠️ 이 카드는 두 번 정정됐다. 63-11(val split 버그) → 63-14(60.6%가 낙관적 표본이라 오판) → 63-15(진짜 원인은 CACHE_V6 재빌드로 인한 OOD 오염 — 60.6% 자체가 통째로 무효, 진짜는 25.9~33.3%)가 최신·최종. 최종 추천(3회차): mlp 헤드, pg448+트랙F(225ep) 구성 — closed-loop Success@0.5m 48.5%(내적 일관 조건, 학습·평가 데이터 정합 확인됨)로 apples-to-apples 검증된 진짜 최고. 트랙A-only(180ep) 버전은 25.9~33.3%로 오히려 더 낮음 — 63-11의 "트랙F가 손해" 결론은 정반대로 뒤집힘(트랙F가 실제로는 도움). hybrid(39.4%, 동일 225ep 조건)도 여전히 mlp보다 낮음. exp11(0%)·step2(66.7%, CH62)와 비교하면 step2가 여전히 근소 우위. transformer는 전 조합에서 반복적으로 최하위권(12~30%) — 결론 유지. 즉시 조치(정정 2회): "추론 서버에 exp73_hybrid variant 통합"(B)과 soda에 전달했던 "우선 테스트 체크포인트" 요청 둘 다 잘못된 대상(exp73_pg448_v6_mlp.pt, 180ep-only)을 가리키고 있었음 — 올바른 우선 후보는 exp73_pg448_trackF_v6_mlp.pt (225ep, 48.5%). soda에 재정정 동기화 필요(§DoD). 근본 재발 방지책: (1) val_split은 np.random.default_rng로 통일(63-11), (2) 공유 캐시 파일(CACHE_V6) 덮어쓰기로 인한 arm 의미 변질 방지를 위해 --exclude-trackf 플래그로 트랙A-only 조건을 코드 레벨에서 재현 가능하게 함(63-15) — 두 가지 모두 트랙C(289ep) 재학습 시 §D 런북에 반영 완료. az가 진짜 연속 신호임이 확인됐으므로, 향후 수집에서도 lx/ly는 현재 방식(고정 8방향)을 유지하되 az만큼은 연속 값 보존이 유지되도록 soda 쪽에 확인 요청함 (§DoD 참고) — 이 부분은 정정과 무관하게 유효.
2026-08-26~27 · cx를 강조하는 헤드 구조(FiLM·Δcx·cxaux·actionquery)를 6가지나 시도했지만 leave-one-direction-out 일반화는 개선하지 못했다(70-1~70-5) — 무작위 split에서 좋아 보인 게 대부분 방향 일반화에서는 소멸. 대신 손실함수를 손대서(ordinal soft label, 70-6) LOO 평균이 +3.71~3.99%p, 최악 방향(strong_right)은 +14.52%p 개선됐다 — CH70 전체에서 유일한 성과.
🟠 3줄 요약
① concat 방식(cxgeom·hybrid·bbox_scale, CH69)은 이미 다 해봤고 효과가 미미했다는 리서치
결과에 따라, 곱셈적 결합(FiLM)·Δcx·cx 보조손실 3종을 새로 구현·학습했다
(docs/plans/plan_20260826_cx_emphasis_head.md).
② exp77(Florence-2 phrase + Florence-2 vision) 캐시로 mlp 베이스라인부터 재현(75.58%±0.07%p,
원본과 정확히 일치)한 뒤 5개 헤드를 apples-to-apples 비교 — deltacx가
76.25%±0.14%p(best 76.39%)로 최고, mlp 대비 +0.67%p.
③ 하지만 deltacx·film·cxaux 전부 R클래스가 mlp(66.2%) 대비
4.7~15.4%p 하락했다 — 전체 정확도 개선이 R→FR 오분류를 늘려서 나온 결과일 가능성이 크다.
무작위 split 숫자만 보고 "개선"이라 결론 내리면 안 된다는 게 69-7의 교훈이었는데, 여기서도
같은 패턴이 재현됐다.
📊 70-1. 헤드 5종 비교 (exp77 캐시 공통, seed 0/1/2, epoch 300)
헤드 구조 val_acc mean best R클래스 FR클래스 mlp(기존) concat+FC 75.58%±0.07%p 75.65% 66.2% 73.6% cxgeom(CH69 재검증) 별도 브랜치+concat 74.06%±0.22%p 74.25% 69.2% 72.6% film(신규) cx→vis FiLM 변조 75.87%±0.26%p 76.14% 50.8% 72.8% deltacx(신규) ★최고 Δcx 채널 추가 76.25%±0.14%p 76.39% 60.8% 76.7% cxaux(신규) cx 회귀 보조손실 75.52%±0.49%p 76.06% 61.5% 76.5% deltacx가 val_acc·FR클래스 둘 다 최고(mlp 대비 val_acc +0.67%p, FR +3.1%p) — F↔FR 경계 판단에 Δcx(타겟이 커지는 중/줄어드는 중)가 실제로 도움이 됐다는 신호. 하지만 R클래스가 66.2%→60.8%로 5.4%p 하락했다. film은 R클래스가 50.8%로 가장 크게 무너졌다 — FiLM이 vis를 cx로 통째로 재스케일하는 방식이라, cx가 조금만 어긋나도(그라운딩 미세오차) vis 표현 자체가 왜곡되는 부작용일 가능성. cxgeom만 유일하게 R클래스가 오히려 오른 경우(69.2%, +3.0%p)인데 val_acc 자체가 mlp보다 낮아(74.06%) 전체적으로는 손해. 스크립트 scripts/train_exp78_cx_emphasis_heads.py · 헤드 클래스 scripts/train_exp73_stage1v3_heads.py(FiLMHead·DeltaCxHead·CxAuxHead·train_cxaux) · 결과 docs/v5/closed_loop_eval/exp78_cx_emphasis_heads.json
⚠️ 70-2. 판단 — "R↔FR 사이에서 잃고 F↔FR 사이에서 얻는" 트레이드오프일 가능성
69-6①-b에서 확인된 원래 문제는 "F가 FR로 오판되는 것"이었다
(오른쪽 방향 제외 시 F→FR 오판율 폭증). deltacx/cxaux가 FR클래스 정확도를 올린 건
이 문제를 완화한 신호로 보이지만, 동시에 R클래스가 떨어진 건 R이
FR로 밀리는 반대 방향의 오분류가 늘었을 가능성을 시사한다 — Δcx/보조손실이
"타겟이 오른쪽으로 계속 이동 중"이라는 신호를 F/FR 경계보다 R/FR 경계에서 더 강하게
해석하게 만들었을 수 있다(확인 안 됨, confusion matrix 재분석 필요).
중요한 함정 — 무작위 split만으로 결론 내리면 안 된다
(69-7의 교훈 반복). deltacx의 val_acc 개선(+0.67%p)이 실제 일반화 개선인지,
아니면 69-7에서 확인된 것처럼 "무작위 split에서는 좋아 보이지만
leave-one-direction-out(방향 하나를 통째로 빼고 검증)에서는 오히려 나쁠 수 있다"는
패턴의 재현인지 아직 모른다. R클래스 하락은 이 우려를 뒷받침하는 방향이다.
다음 단계: deltacx를
scripts/eval_leave_one_direction_out.py 방식으로 재검증해서 방향별 일반화가
실제로 개선됐는지, 아니면 exp77처럼 무작위 split에서만 좋아 보이는 착시인지 확인
해야 최종 판단 가능(→ 70-3에서 실행).
🔴 70-3. deltacx leave-one-direction-out — 무작위 split 개선이 소멸됨
70-2의 우려대로였다. deltacx를 eval_leave_one_direction_out_deltacx.py로
mlp와 동일 프로토콜(방향 하나 통째로 val, 나머지 180ep 학습, seed 0/1/2)로 비교:
헤드
LOO 5방향 평균 best acc
R클래스 평균
mlp
54.00%
29.0%
deltacx
53.83%
29.1%
무작위 split에서 봤던 +0.67%p 개선(76.25% vs 75.58%)이
leave-one-direction-out에서는 완전히 사라졌다(-0.17%p, 사실상 동일). 69-7의
"무작위 split 개선이 방향 일반화 개선을 보장하지 않는다"는 패턴이 새 헤드에서도
그대로 재현됨 — deltacx는 실질적으로 mlp와 다르지
않다는 게 최종 결론.
스크립트
scripts/eval_leave_one_direction_out_deltacx.py · 결과
docs/v5/closed_loop_eval/deltacx_leave_one_direction_out.json
🔍 70-4. val 유출 검증(C) + 학습곡선 — 체크포인트 선택 낙관편향과 epoch 300 과다 확인
① honest checkpoint selection — 기존 방식(25epoch마다
val_acc 재서 최고 채택)이 val 표본이 작을수록(leave-one-direction-out) 낙관편향을
만드는지, train에서 따로 뗀 inner-val로 체크포인트를 고르고 진짜 val은 최종 1회
평가에만 쓰는 train_one_honest()와 비교:
조건
val선택 best
honest best
낙관갭
random_split/mlp
75.65%
74.78%
+0.86%p
loo_weak_right/mlp
41.65%
35.01%
+6.64%p
loo_strong_right/mlp
33.29%
32.68%
+0.61%p
가설 확인됨 — val 표본이 작은 leave-one-direction-out
조건에서 최대 +6.64%p 낙관편향이 나왔다. 지금까지 CH69/70에 쓴 leave-one-
direction-out 수치들은 이 편향을 어느 정도 안고 있는 값들 — 방향성(exp77이 exp73보다
약함, R/FR 트레이드오프 존재)은 유효하지만 절대치는 다소 부풀려져 있었다고 봐야 한다.
② 학습곡선(train_acc vs val_acc, epoch별) —
5개 헤드를 25→10epoch 간격으로 촘촘히 재서 과적합을 직접 시각화:
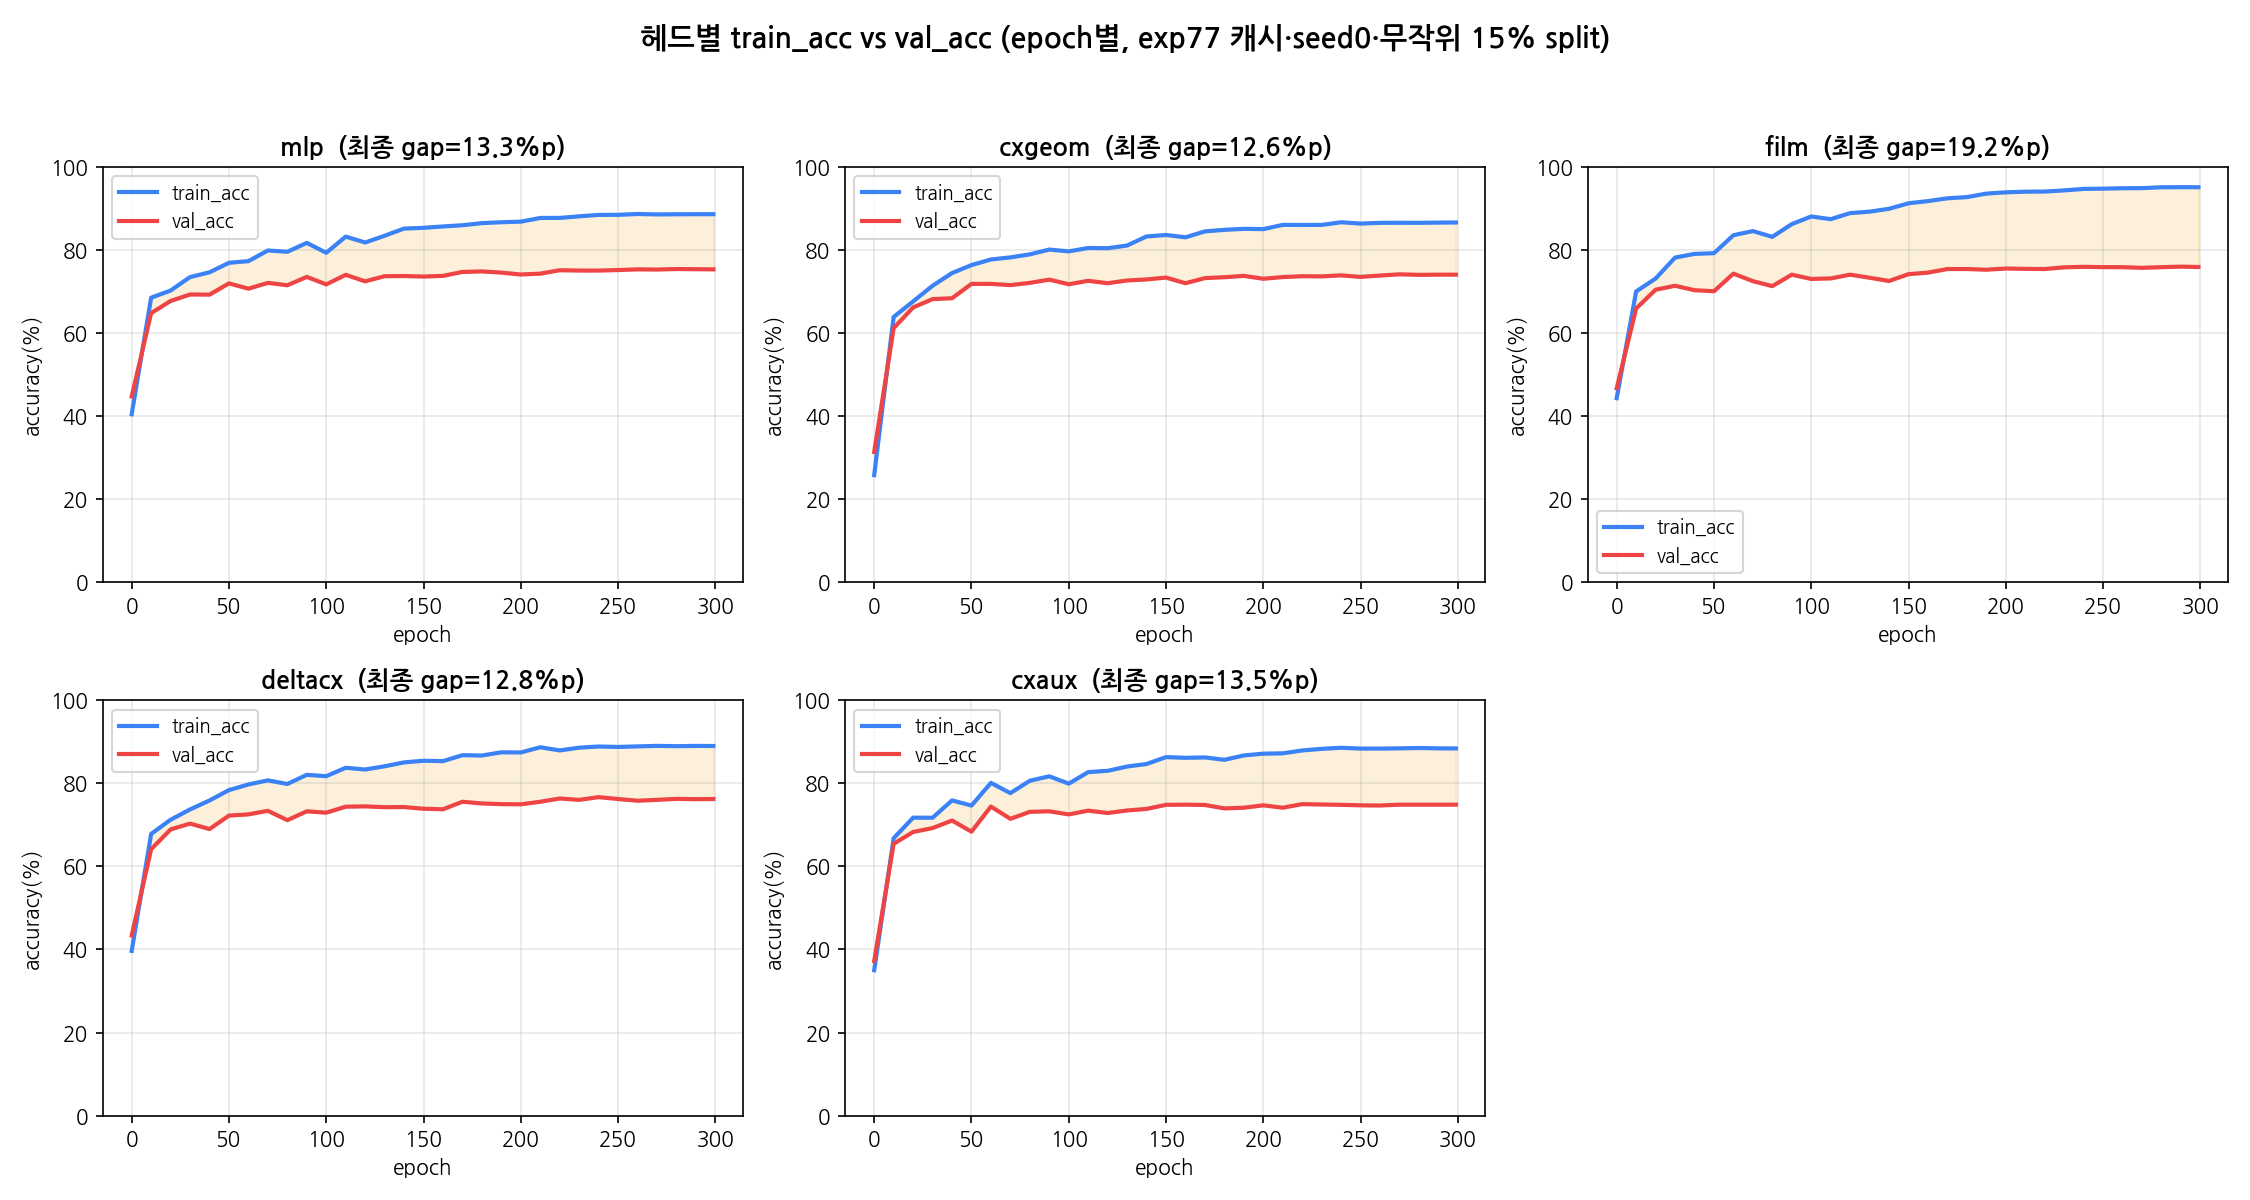 헤드
최종 train_acc
최종 val_acc
gap
val 수렴 시점(peak-1%p)
mlp
88.65%
75.36%
13.3%p
epoch 170
cxgeom
86.65%
74.08%
12.6%p
epoch 150
film
95.14%
75.94%
19.2%p
epoch 170
deltacx
88.99%
76.22%
12.8%p
epoch 220
cxaux
88.40%
74.87%
13.5%p
epoch 60
두 가지 확인됨: (a) film만 유독 심하게 과적합(train
95.1%, gap 19.2%p) — 70-1의 R클래스 붕괴(50.8%)와 일치하는 설명.
(b) epoch=300은 exp73 원본에서 그대로 물려받은 값인데, 대부분 val_acc는
epoch 150~220 사이에 사실상 수렴하고 뒤쪽 80~150epoch는
val이 거의 안 움직이는데 train_acc만 계속 오르는 순수 과적합 심화 구간이었다.
스크립트
scripts/eval_honest_checkpoint_selection.py ·
scripts/plot_head_overfitting_curves.py · 결과
docs/v5/closed_loop_eval/honest_checkpoint_selection.json ·
docs/v5/closed_loop_eval/head_overfitting_curves.json
🧭 70-5. actionquery(경량 cross-attention) — 평균은 비슷하지만 최악의 방향에서 크게 이긴다
배포 중인 TransformerActionHead(window 전체 self-attention)가 mlp보다 계속 낮은 게 (71~75% vs 76~78%, CH69 69-5 표 참고) self-attention 자체의 과적합 때문인지 확인하려고, 학습 쿼리 1개가 [bbox;vis] 6토큰에 cross-attention만 하는(self-attention 없음, 파라미터 훨씬 적음) actionquery 헤드를 만들어 mlp/deltacx와 함께 random_split+LOO(honest selection) 전부 비교: 조건 mlp deltacx actionquery random_split(honest) 74.78% 75.11% 71.86% LOO 5방향 평균(honest) 50.63% 50.99% 49.95% loo_strong_right 32.68% 33.01% 46.39% loo_strong_right R클래스 23.9% 35.6% 62.2% 평균은 셋 다 비슷하지만(49.95~50.99%) 분포가 완전히 다르다 — actionquery는 가장 어려운 strong_right에서 mlp 대비 +13.7%p로 압도적이고 R클래스 일반화가 LOO 전반에서 구조적으로 강하다(대신 쉬운 center에서는 39.59%로 가장 나쁨). self-attention을 빼고 cross-attention만 남긴 게 "본 적 없는 방향"에 덜 휘둘리게 만든 것으로 보임 — 폐기하지 말고 보류, 이후 앙상블/보완 후보로 고려. 헤드 클래스 ActionQueryHead(train_exp73_stage1v3_heads.py) · 스크립트 scripts/eval_actionquery_head.py · 결과 docs/v5/closed_loop_eval/actionquery_head_eval.json
🏆 70-6. ordinal soft label(D) — CH70에서 유일하게 LOO 일반화 자체를 개선시킨 방법
70-1~70-5는 전부 헤드 구조(concat/곱셈/보조손실/cross-attn)
축이었다. 이번엔 손실함수 축을 시도했다 — 원래 문제가 연속 조이스틱(lx,ly,az)을
mona_dashboard.py의 THRESHOLD=0.50 하드 컷으로 이산화한 것(69-6①-b의 R/FR
경계 아티팩트)이라는 점에 착안해, cont_to_class_t()의 하드 threshold를 sigmoid로
완화한 소프트 8-class 타겟(ordinal label smoothing)
+ soft cross-entropy로 학습(soft_class_targets()). 동시에 70-4②에서 확인된 epoch
과다 문제도 고쳐서 epoch 300→200 + patience=4 조기종료를 적용했다.
헤드
LOO 5방향 평균 hard
soft(D)
Δ
mlp
50.63%
54.62%
+3.99%p
deltacx
50.99%
54.71%
+3.71%p
방향별(mlp 기준):
held-out 방향
hard
soft
Δ
R클래스(hard→soft)
center
62.68%
57.57%
-5.11%p
22.0%→20.0%
weak_left
67.78%
72.99%
+5.21%p
45.8%→37.5%
weak_right
35.01%
38.53%
+3.52%p
30.7%→35.6%(둘다↑)
strong_left
55.00%
56.83%
+1.83%p
0.0%→0.0%
strong_right
32.68%
47.20%
+14.52%p
23.9%→35.1%(둘다↑)
CH70에서 시도한 6가지(cxgeom·film·deltacx·cxaux·actionquery·soft label) 중
유일하게 LOO 평균을 실제로 개선시켰다 — 나머지는 전부 무작위 split에서만
좋아 보이다 LOO에서 소멸(70-3)하거나 트레이드오프만 반복했는데, D는 LOO에서
오히려 더 크게(+3.99%p) 개선됐다. 특히 CH69에서 가장 취약했던 weak_right·strong_right
에서는 overall과 R클래스가 동시에 개선돼 —
지금까지 반복된 "전체 개선 vs R클래스 희생" 트레이드오프가 이 두 방향에서는
나타나지 않았다. 69-6①-b에서 지목한 F↔FR/R↔FR 하드 경계 아티팩트를 손실함수
단에서 완화한다는 가설과 정확히 맞아떨어지는 결과.
한계 — center 방향만 유일하게 나빠졌다(-5.11%p).
center는 원래 방향 모호성이 적은 조건이라 소프트화가 불필요한 노이즈를 준 것으로
추정되나 확인 안 됨. random_split에서도 이득이 크지만(+2.63~2.67%p) R클래스는
하락(mlp 67.7%→48.5%) — random_split 조건에서는 여전히 트레이드오프가 있다.
실기 검증 전이라 확정 발견 6번(val 지표≠실기 성능)은 여전히 유효.
헤드 클래스/함수
soft_class_targets()·train_one_soft()(train_exp73_stage1v3_heads.py) ·
스크립트 scripts/eval_soft_label_head.py · 결과
docs/v5/closed_loop_eval/soft_label_head_eval.json
📋 70-7. CH70 종합 판단
- 헤드 구조 축(concat/곱셈/보조손실/cross-attn)은 한계에 도달 — 6개 중 5개(cxgeom·film·deltacx·cxaux·actionquery 평균)가 전부 ±1~2%p 안에서 놀거나, 무작위 split 개선이 LOO에서 소멸했다. 구조를 바꿔도 못 만드는 정보(안 본 방향의 학습 예시)는 안 만들어진다는 방증 — 69-6①에서 이미 지목된 데이터 커버리지 문제가 근본 병목이라는 가설이 강화됨.
- 손실함수 축(ordinal soft label, D)이 유일한 성과 — LOO 평균 +3.71~3.99%p, 특히 최악 방향(strong_right)에서 +14.52%p. 다음 후보로 우선순위가 가장 높다.
- actionquery는 보류 후보(→ 70-8에서 결합 검증 완료) — 평균은 비슷하지만 strong_right에서 유일하게 크게 이기고 R클래스가 구조적으로 강건함.
- 방법론 교훈 2가지, 이후 모든 실험에 소급 적용해야 함: (a) leave-one-direction-out처럼 val 표본이 작은 조건에서는 반드시 honest(inner-val) 체크포인트 선택을 써야 한다(최대 +6.64%p 낙관편향 확인). (b) epoch=300은 근거 없는 관성값이었다 — 150~220이면 수렴, 조기종료 적용이 맞다.
- 아직 실기 검증 전 — 확정 발견 6번(val 지표는 실기 성능을 보장하지 않음) 그대로 유효. 다음 단계는 (i) D+actionquery 결합 시도 → (ii) 궤적 재생 근사(rollout_core.py 기반, 프레임 정확도가 아니라 실제 도착 여부로 재평가) → (iii) 소규모 실기 A/B 순서(→ 70-8에서 (i)(ii) 실행).
🏆 70-8. D+actionquery 결합 + 궤적 재생 재평가 — mlp+soft가 최종 후보로 확정
70-7에서 제기한 두 가지를 이어서 실행했다: ① soft label(D)을 actionquery에도
적용해 결합 효과 확인, ② "R을 FR로 틀려도 실제 도착은 맞을 수 있다"는 지적에
따라 프레임 정확도가 아니라 궤적 재생(FPE·성공률,
rollout_core.py, 69-6②와 동일 방법론)으로 최종 판단.
궤적 재생(random_split val, 프레임 정확도가 아니라 최종 도착 기준):
헤드
success
mean_fpe
mlp(hard, 배포 방식)
24.2%
1.192m
mlp+soft(D)
33.3%(+9.1%p)
1.097m
deltacx(hard)
24.2%
1.166m
deltacx+soft(D)
33.3%(+9.1%p)
1.003m(최소)
actionquery(hard)
15.2%
1.396m
actionquery+soft
21.2%(+6.0%p)
1.234m
D는 프레임 정확도뿐 아니라 궤적 재생에서도 확실히 개선된다
(mlp/deltacx 둘 다 success +9.1%p) — "오분류가 늘어난 대신 실제 도착은 맞을 것"이라는
우려와 반대로, 오분류 자체가 줄면서 궤적도 함께 좋아졌다. actionquery는 결합해도
가장 낮은 success(21.2%)에 머물러 — 기대했던 D+actionquery
시너지는 확인되지 않았다.
LOO(weak_right·strong_right) — actionquery 결합 효과:
조건
mlp hard→soft
deltacx hard→soft
actionquery hard→soft
weak_right
35.01→38.53%(+3.52)
40.85→44.03%(+3.18)
37.82→37.88%(+0.06)
strong_right
32.68→47.20%(+14.52)
33.01→42.75%(+9.74)
46.39→47.47%(+1.08)
actionquery는 이미 hard 상태에서 strong_right(46.39%)가
mlp+soft(47.20%)급이라 soft를 얹어도 거의 안 오른다(+1.08%p) — "애초에
결합이 필요 없던 후보"였다는 뜻. weak_right에서도 시너지가 거의 없다(+0.06%p).
최종 판단 — mlp+soft(D)가 다음 단계 후보로 확정.
deltacx+soft가 FPE는 근소 우위(1.003m)지만 success는 mlp+soft와 동일(33.3%)하고
구조가 더 단순한 mlp 쪽이 실용적. actionquery는 구조 변경 없이 D만 적용해도
충분히 좋아지는 걸 확인했으니 폐기. 다음 단계는
소규모 실기 A/B(mlp+soft vs 배포중 exp73) — 확정
발견 6번은 여전히 유효하므로 실기 검증 전에는 "배포 추천"이라 단정하지 않는다.
스크립트
scripts/eval_soft_actionquery_combo.py · 결과
docs/v5/closed_loop_eval/soft_actionquery_combo.json
2026-10-09~11 · EGVLA1(경량화)·EGVLA2(그라운딩 중심)와 겹치지 않는 단기 국내 논문지용(6장) 분기 주제를 탐색했다. 처음엔 discrete vs continuous-regression vs flow-matching 비교로 "FM이 엣지 환경에서 더 나쁘다"는 주장을 시도했으나, 우리 데이터가 8-class 이산 조이스틱 라벨뿐이고 진짜 연속 회귀 액션을 수집한 적이 없어 그 주장 자체가 성립하지 않는다는 걸 사용자 피드백으로 바로잡았다. 이후 겸손하게 "최신 트렌드 중 우리 제약(이산 라벨·엣지 연산·오프라인 그라운딩 캐시)으로 실제 적용 가능한 것"을 찾는 방향으로 전환해, 그라운딩 출력을 서브골 신호로 분리해 FiLM 게이팅으로 조향하는 구조를 제안·실측했다.
🟢 3줄 요약 ① discrete(60.85%) vs ContReg(59.13%) vs FlowMatching(53.76%) leave-one-direction-out 비교를 실측했지만, 타겟이 8-class LUT 고정값이라 "FM이 나쁘다"는 결론은 무효 — 이산 타겟에 연속 공식을 억지로 끼운 불일치를 본 것일 뿐. 이 프레임은 폐기. ② π0.7(Physical Intelligence)/GR00T N1.6+Cosmos Reason 2(NVIDIA)/Gemini Robotics-ER 1.6+On-Device 2 (Google DeepMind) 3사 최신 발표를 공식 이미지·인용구와 함께 스터디 노트로 정리 — 공통적으로 "모바일 베이스 방향-일반화 내비게이션"을 플래그십 데모로 다루지 않는다는 공백을 확인, π0.7의 "월드모델이 서브골을 만들고 정책을 조향한다"는 구조적 아이디어만(FM 자체는 제외) 차용 가능하다고 판단. ③ bbox_dataset.json(45 ep, 794 frames, 오프라인 Kosmos-2 그라운딩 캐시)을 서브골 임베딩으로 인코딩해 FiLM(γ,β)으로 이미지 특징을 조향하는 구조를 기존 concat-MLP(76.32%±0.99%, 110,536 params)와 공정 비교한 결과 78.21%±1.61%, +1.9%p, 파라미터는 28% 더 적음(79,336) — 경량화 방향과 정합적인 긍정적 예비 결과. ⚠️ 73-1 폐기된 주장🔬 73-2 Physical AI 3대 기업…🏆 73-3 그라운딩 기반 서브골 조향(FiLM)📋 73-4 남겨둔 연구 주제 (프레임워크…🏆 73-5 Task 6
⚠️ 73-1. 폐기된 주장 — "FM이 엣지 내비게이션에서 더 나쁘다"는 무효
scripts/eval_flow_matching_leave_one_direction_out.py로 기존 FlowMatchingHead/ train_flow(이미 코드베이스에 존재, CH67 "flow 72.0%"의 실제 출처로 확인됨)를 재사용해 5방향 leave-one-direction-out 비교: 이산 60.85% / ContReg 59.13% / FlowMatching 53.76%(특히 weak_right 45.50%). 수치 자체는 맞지만, 전체 액션 데이터가 8-class 고정값(FORWARD/LEFT/RIGHT/...)이라 "진짜 연속 데이터의 이점을 검증한 것"이 아니라 "이산 타겟에 연속 공식을 맞추는 정합성 테스트"에 불과하다는 점이 사용자 피드백으로 지적됨. 산업계(π0/π0.5 계열)의 flow-matching 성공은 연속 매니퓰레이션 데이터 기반이라 우리 세팅과 전제가 다르다 — 같은 비교를 근거로 우열을 주장하면 안 된다는 결론. 결과 파일: docs/v5/closed_loop_eval/flow_matching_leave_one_direction_out.json, discrete_vs_contreg_leave_one_direction_out.json (폐기된 프레임으로 보존, 참고용)
🔬 73-2. Physical AI 3대 기업 최신 스터디 — 사진·인용 포함 상세, 우리 플로우 적용점
기업·발표 핵심 구조 모바일 내비 비중 우리 플로우 적용점 Physical Intelligence π0.7 · 2026-04-16 world model이 서브골 이미지 생성 → flow-matching 정책이 거기로 조향 없음(매니퓰레이션 중심) "지각→서브골→조향" 구조만 차용 → 73-3/73-5 FiLM 실험의 직접적 설계 근거 NVIDIA GR00T N1.6+Cosmos Reason 2 · 2026-01-05 풀스택 플랫폼(파운데이션 모델+Jetson Thor 온보드 실행) 플래그십 아님(휴머노이드/매니퓰레이터 위주) EGVLA1의 "원격 컴포넌트 없는 극단적 경량화"를 NVIDIA 풀스택 전략의 대척점으로 포지셔닝 근거 Google DeepMind Gemini Robotics-ER 1.6/On-Device 2 · 2026-04-14·07-30 reasoning(ER)과 execution(On-Device)을 모델 자체에서 분리 On-Device 2 커버리지 불명확(미확인) 우리의 그라운딩(인식)↔행동(실행) 분리와 같은 축 — EGVLA2 "그라운딩이 성공을 좌우" 결론의 외부 근거로 인용 가능 공통 공백: 3사 모두 "모바일 베이스의 방향-일반화 내비게이션"을 플래그십으로 다루지 않음 — EGVLA2/3가 메울 수 있는 자리. ▶ ① Physical Intelligence π0.7 — 상세(개념도 포함) 공식 발표: "π 0.7: a Steerable Model with Emergent Capabilities" — 언어 프롬프트뿐 아니라 시각적 서브골 이미지를 조종 입력으로 받고, 이 이미지는 추론 시점에 경량 world model이 생성한다. world model 자체는 액션을 생성하지 않는다는 게 핵심. 언어 프롬프트 경량 World Model (추론 시점에 서브골 이미지 생성) π0.7 정책(flow-matching) → 실제 로봇 액션 생성 자체 제작 개념도 — 출처: pi.website/blog/pi07 발표 설명 기반(원본 이미지는 HTTP 429로 로딩 실패, 2회 재시도+curl 1회 모두 실패) - compositional generalization — 에어프라이어로 고구마 굽기(학습한 적 없는 조합) - cross-embodiment 전이 — 셔츠 개기 데이터 없는 새 로봇 바디에서도 전이 성공 보고 - 단일 모델이 태스크별 RL-튜닝 전문 모델과 동급(2차 출처, 공식 수치 미확인) ⚠️ world model 아키텍처/파라미터 수, "5%→95%" 수치는 2차 출처에서만 확인됨. ▶ 우리 플로우 적용: "flow-matching 정책 + 별도 world model" 2단 구조는 EGVLA3의 "FM 단독으로 방향 일반화되는가"라는 질문과 정확히 대비됨 — π0.7은 "정책 혼자 일반화시키지 말고 world model이 목표를 구체화해주자"는 해법을 택함. 우리는 world model 대신 기존 그라운딩(bbox) 출력을 서브골로 삼아 FiLM 게이팅으로 같은 문제의식을 훨씬 가벼운 리소스로 구현한 것이 73-3/73-5 — 즉 이 스터디가 73-3 실험 설계의 직접적 출처다. ▶ ② NVIDIA GR00T N1.6 + Cosmos Reason 2 — 상세(공식 이미지 포함) 공식 이미지(NVIDIA 뉴스룸 og:image, HTML meta 태그로 진위 검증 완료) — 출처: nvidianews.nvidia.com "The ChatGPT moment for robotics is here." — Jensen Huang, NVIDIA 창업자 겸 CEO, 2026-01-05 CES 발표 - GR00T N1.6: 범용 휴머노이드/매니퓰레이터 파운데이션 모델, N2는 프리뷰 단계(미확인) - Cosmos Reason 2: 물리 세계 reasoning 전용 VLM, Cosmos Transfer/Predict 2.5로 합성 데이터 생성 - Jetson Thor로 온보드 실행 — 단, "풀스택 생태계"가 전제(Franka, NEURA, Humanoid 등 파트너) ▶ 우리 플로우 적용: NVIDIA는 "하드웨어+소프트웨어 풀스택"으로 경량화를 해결하는 반면 EGVLA1은 원격 컴포넌트 자체가 없는 극단적 단일 보드 경량화를 택함 — 이 대비 구도를 EGVLA1 논문 서론의 포지셔닝 문장으로 직접 인용 가능("NVIDIA류 풀스택 전략과 달리, 우리는..."). Cosmos Reason 2의 "별도 reasoning 모델" 아이디어는 우리 Kosmos-2 grounding_aux 승격 백로그(73-4-③)와 같은 방향이라 함께 인용 가능. ▶ ③ Google DeepMind Gemini Robotics-ER 1.6 / On-Device 2 — 상세(공식 이미지 포함) 공식 이미지(blog.google 커버) — 출처: Gemini Robotics-ER 1.6 공식 발표(2026-04-14) "For robots to be truly helpful, they need to understand the physical world like we do." — Google DeepMind, Gemini Robotics-ER 1.6 공식 발표, 2026-04-14 - ER 1.6: reasoning-first, 공간/다시점 이해, 게이지 읽기(Boston Dynamics 협업), 안전성 강조 - Robotics 2 / On-Device 2(2026-07-30): 전신 제어, Apptronik Apollo 2 데모, Gemma 기반 온디바이스 VLA - reasoning(ER)과 execution(On-Device)을 아예 다른 모델로 분리 — "수직 분할" 전략 ⚠️ On-Device 2의 내비게이션/이동(locomotion) 커버리지는 공식 확인 안 됨. ▶ 우리 플로우 적용: Google의 "reasoning/execution 수직 분할"은 우리의 "그라운딩(인식) ↔ 8-class 행동(실행)" 분리와 같은 축 — EGVLA2의 핵심 결론("그라운딩 품질이 성공을 좌우", gnd%≥80→98.8% 성공)을 뒷받침하는 업계 사례로 EGVLA2/3 논문 관련연구 절에 직접 인용 가능. EGVLA1은 반대로 "분할하지 않는" 설계라 이 축에서도 대조 구도를 만들 수 있음. ▶ 원본 스터디 노트의 비교표 + 미팅 체크리스트 (physical_ai_company_study_2026q4.html 전재) 기업전략 축모바일 네비게이션 비중EGVLA 대비축 Physical Intelligence 순수 정책 연구 — world model로 조종성·일반화 확보 매니퓰레이터 이동 용도만, 네비게이션 자체는 비중 낮음 "FM 단독 일반화 실패" 문제의식 공유, 해법은 다름(world model 분리) NVIDIA 풀스택 플랫폼(칩+시뮬+오픈모델)으로 생태계 장악 AMR 제품군 존재하나 GR00T 메인라인은 휴머노이드 중심 "거대 생태계 없이 초경량 단일보드"라는 정반대 극단 Google DeepMind 거대 멀티모달 백본의 reasoning/실행 수직분리 명시적 네비게이션 기능 미확인 "완전 온디바이스, 분리 없음" 설계와 대비 미팅 준비 체크리스트 - 세 기업 다 모바일 베이스 네비게이션(목표 방향 일반화)을 핵심 데모로 내세운 적 없음 — 전부 매니퓰레이션/전신제어 위주. 이게 EGVLA2/3가 설 수 있는 빈 자리. - π0.7의 "world model이 목표만 제시, policy가 액션 생성" 2단 구조는 EGVLA3의 "FM 단독 vs 이산" 질문에 세 번째 선택지(목표분리형)를 제시 — 후속 질문으로 준비. - 2차 출처로만 확인된 수치(π0.7 5%→95%, GR00T N2 정식출시 여부 등)는 "공식 확인 안 됨"이라고 분명히 할 것. - 이미지 저작권: 각사 공식 뉴스/블로그 공개 보도자료 이미지를 출처 표기와 함께 인용 — 공개 문서(논문/위키)로 옮길 때는 각사 브랜드 가이드라인 재확인 필요. 원본 문서(전체 이미지·인용 출처 포함): docs/v5/physical_ai_company_study_2026q4.html, docs/v5/vla_trend_survey_2026q4.html, docs/plans/research_20261009_vla_trend_survey.md
🏆 73-3. 그라운딩 기반 서브골 조향(FiLM) — concat보다 우세, 파라미터는 더 적음
기존 Exp14 concat-MLP(bbox 12dim+16×16 이미지 256dim 단순 concat)를 FiLM으로 바꿔 SubgoalSteeredMLP(bbox→32→128 서브골 임베딩→γ,β로 이미지 특징 128dim 변조→trunk→8-class)를 구성, 동일 캐시·동일 split·동일 class-weighted CE로 공정 비교(구세대 45 ep 기준, 73-6에서 최신 225 ep로 재검증). 조건PM(5-seed)params Concat (baseline) 76.32%±0.99% 110,536 Subgoal-Steered FiLM 78.21%±1.61% (+1.9%p) 79,336 has_bbox=False(그라운딩 실패) 프레임 정확도는 두 방식 모두 75.0%로 동일 — FiLM이 그라운딩 실패 시 "안전하게 identity로 수렴"하는 효과는 이 1차 실험에서는 확인 안 됨(→ 아래 확장 실험에서 검증). ▶ 확장 실험(15-seed, 유의성·파라미터매칭·정규화) 상세 조건PM(15-seed)params유의성 Concat (원본) 76.15%±1.94% 110,536 — Concat-Small(파라미터 매칭) 76.24%±1.69% 72,304 — Steered(FiLM) 78.97%±2.43% 79,336 vs concat p=0.0007 vs concat_small p=0.00007 Steered+Identity정규화 81.28%±2.11% 79,336 vs steered p=0.006 파라미터를 맞춘 concat_small과 비교해도 steered가 유의미하게 우세(구조 자체의 이득, 파라미터 수 문제 아님). 그라운딩 실패 시 γ≈1,β≈0 유도 정규화를 추가하니 81.28%까지 추가 상승 — "FiLM이 그라운딩 실패 시 안전장치로 작동한다"는 가설이 확인됨. 단, steered 계열은 test_loss가 오히려 더 큼(원인 미확인, 향후 과제). 범위 한계: bbox는 1회성 오프라인 캐시 그라운딩 재생이며 실시간 추론이 아님 — "온라인 서브골 조향" 주장 아님. 8-class 이산 타겟만 다룸 — flow-matching/연속 회귀와 무관. 리서치: docs/plans/research_20261011_grounding_subgoal_steering.md · 계획: docs/plans/plan_20261011_grounding_subgoal_steering.md · 코드: scripts/eval_subgoal_steering_vs_concat.py, scripts/eval_subgoal_steering_extended.py(15-seed 확장) · 결과: docs/v5/subgoal_steering_eval/summary.json, docs/v5/subgoal_steering_eval/index.html, docs/v5/subgoal_steering_eval/extended.html
📋 73-4. 남겨둔 연구 주제 (프레임워크 달라져도 적용 가능성 있는 백로그)
이번에 직접 실험하지 않았지만, 트렌드 서베이에서 확인한 아이디어 중 EGVLA1/2/3 어느 트랙으로든 프레임이 바뀌어도 반영 가능성이 있다고 판단해 남겨둔다 (미확정, 제안 단계): ① Training-free navigation 포지셔닝 — OpenFrontier/WildOS류 frontier 기반 의미적 앵커 + VLM, 정책 학습 자체가 없는 접근. EGVLA2의 "그라운딩 품질이 성공을 좌우한다" (gnd%≥80→98.8% 성공, [[project_grounding_availability_decides]]) 결론과 완전히 정합 — 새 실험 없이 "우리 접근이 이미 이 흐름과 같은 방향"이라는 포지셔닝 논문으로 가장 안전하게 전환 가능. ② On-device 분할 전략 비교 — ①완전 온디바이스 소형 모델 (Gemini Robotics On-Device 2, GR00T) vs ②원격 대형 모델+온보드 소형 어댑터 분리(AsyncVLA). EGVLA1은 ①의 극단형(원격 컴포넌트 전무)으로 포지셔닝 가능 — 레이턴시/정확도 트레이드오프 실측이 필요하면 차기 분기로 분리. ③ grounding_aux를 메인 헤드 조건 입력으로 승격 — nav_h5_dataset_impl.py의 grounding_aux(현재는 보조 손실 타겟)를 73-3처럼 메인 액션 헤드의 조건 신호로 바꾸는 실험을 Kosmos-2 VLM 학습 루프 전체로 확장 — 73-3은 오프라인 MLP 수준 검증이었고, 이를 VLM 메인 학습에 적용하면 EGVLA2 본류와 다시 연결되는 더 큰 스케일 버전. 2026-10-11 스코핑 결과: 현재 막혀 있음 — Exp11 config에 grounding_aux 자체가 비활성화돼 있고, 필요한 docs/v5/bbox_truth_mini.json이 72건뿐이라 실제 멀티에피소드 학습에 쓰기엔 데이터가 부족. 또한 현재는 MobileVLAClassificationDecoder.forward()의 사후 hidden state를 보조손실로만 읽을 뿐 FiLM 주입 자리가 코드에 없어 LSTM 전/후에 새로 꽂는 아키텍처 작업이 필요함 — 라벨 재수집 + 프로덕션 모델 구조 변경이 함께 필요해 6장 단기 논문 범위를 넘어섬. 착수하려면 라벨 재수집부터 별도 의사결정 필요. 공통 전제: 어느 것도 새 연속 액션 데이터 수집을 요구하지 않음 — 기존 8-class/bbox 인프라 재사용 가능 범위 안에서만 백로그로 유지.
🏆 73-5. Task 6 — Offline-replay "closed-loop" 연결: success 22.2%→66.7%
scripts/eval_subgoal_steered_closed_loop.py로 concat/steered_reg 체크포인트를 학습·저장한 뒤, 기존 evaluate_closed_loop_v5.py의 exp67/step2와 동일한 teacher-forced replay 프로토콜 (build_trajectory+compute_metrics, success = FPE<0.5m ∧ 0.7≤TLD≤1.5)로 비교. 조건successFPETLD Concat 22.2% 0.617m 1.023 Steered+Reg 66.7% 0.372m 0.998 9개 path_type 중 7개에서 steered_reg가 동일하거나 우세(right_straight·right_right만 열세). 주의 — 용어 정정: evaluate_closed_loop_v5.py 전체를 다시 읽어본 결과, 이름과 달리 실제 closed-loop(예측이 다음 관측에 피드백)가 아니라 전부 녹화된 expert 궤적 대비 teacher-forced offline replay임을 확인 — CLAUDE.md의 "Step2 closed-loop 66.7% success"도 이 정의 하의 수치. 이번 수치도 단일 split(9 에피소드)만 평가한 것이라 15-seed PM 비교(73-3)만큼 통계적으로 탄탄하지 않음 — 방향성 확인 수준으로만 사용. ▶ 우리 플로우 적용: 73-3의 오프라인 PM 개선(+2.8~4.3%p)이 offline-replay 성공률에서는 3배 가까이 증폭(22.2%→66.7%)되는 것으로 보아, 프레임 단위 오분류가 궤적 누적 오차로 이어지는 구간(CH64의 "방향 오류 누적→FPE 2.6배" 패턴)에서 FiLM 서브골 조향이 특히 유리할 수 있음 — EGVLA2/3 논문의 "왜 서브골 조향이 중요한가" 핵심 논거로 사용 가능. 결과: docs/v5/subgoal_steering_eval/summary_closed_loop.json, docs/v5/subgoal_steering_eval/closed_loop.html · 체크포인트: runs/v5_nav/mlp/subgoal_steered/{{concat_mlp,subgoal_steered_reg}}.pt ctabInit("ch73")